ML Playgrounds: второй курс, каталог по темам и числа, которые зависят от версии библиотеки
К площадкам курса машинного обучения для магистратуры добавились шесть площадок бакалаврского курса программирования систем ИИ на Python, а сайт стал общим каталогом по темам. Что показывает каждая площадка, почему тесты проверяют свойства, а не числа лекций, и что об этом сказала проверка на нескольких версиях Python.
В прошлом разборе площадки повторяли лабораторные одного курса — «Основ машинного обучения» в лингвистической магистратуре. Теперь к ним добавились шесть площадок второго курса, бакалаврского: «Основы программирования систем искусственного интеллекта на языке Python». Сайт из набора приложений стал одним ресурсом: 13 страниц двух курсов разложены по шести темам.
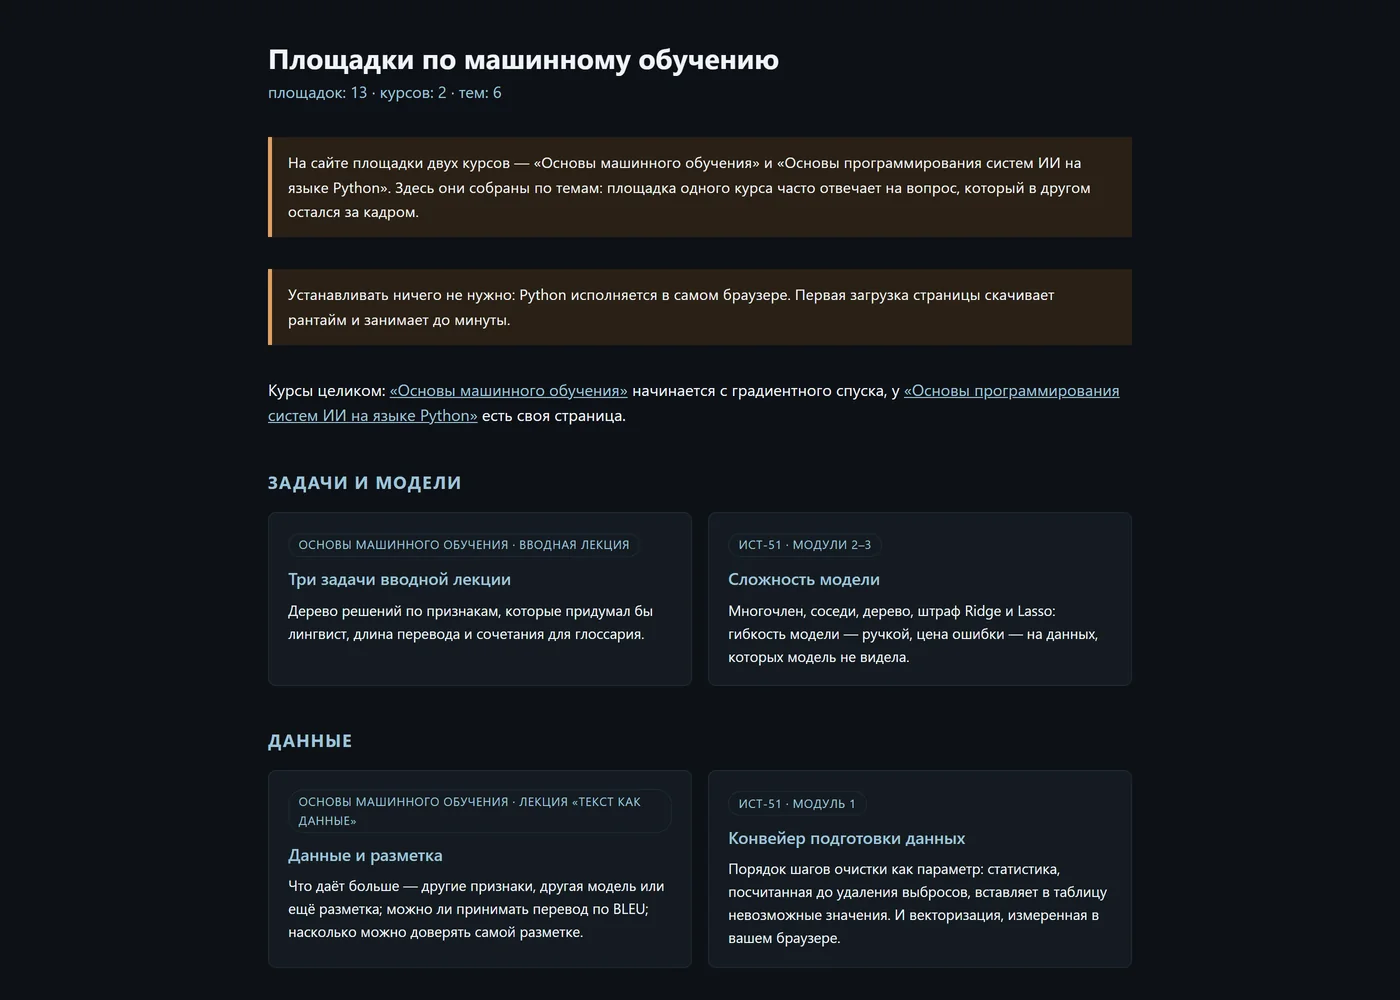
Шесть площадок
Каждая площадка следует одному из модулей лабораторных работ и делает видимой одну ошибку, которую в ноутбуке легко пропустить.
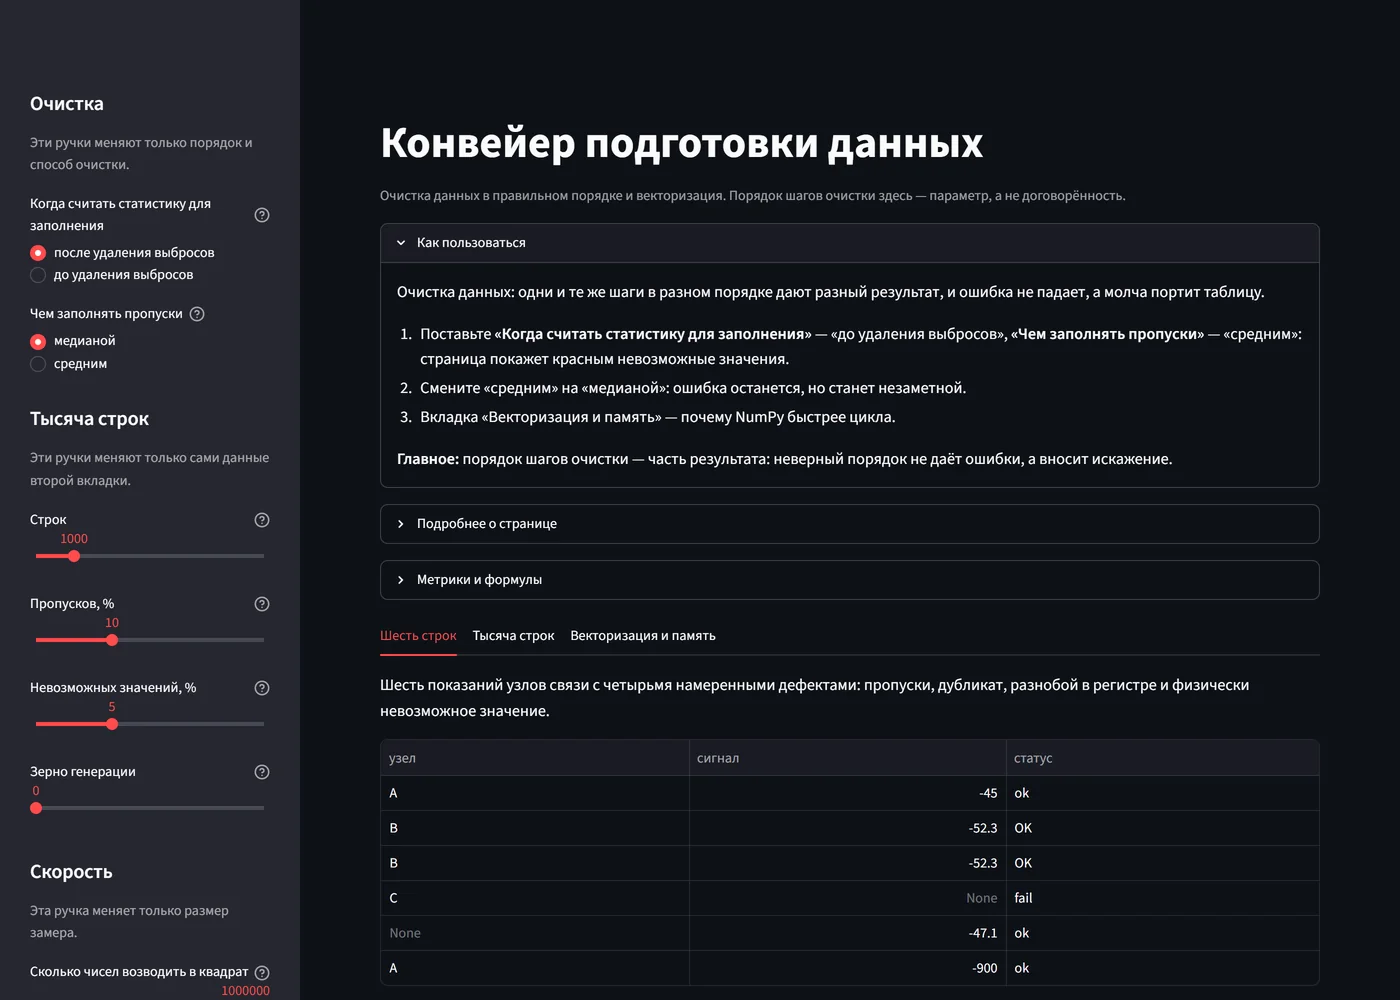
- Конвейер подготовки данных. Порядок шагов очистки — часть результата. Медиана, посчитанная после удаления выбросов, заполняет пропуски значением −48.65. Среднее, посчитанное до удаления, даёт −332.43 — ниже физического предела −120 дБм. Заполнение вносит в таблицу новую ошибку вместо того, чтобы исправить старую.
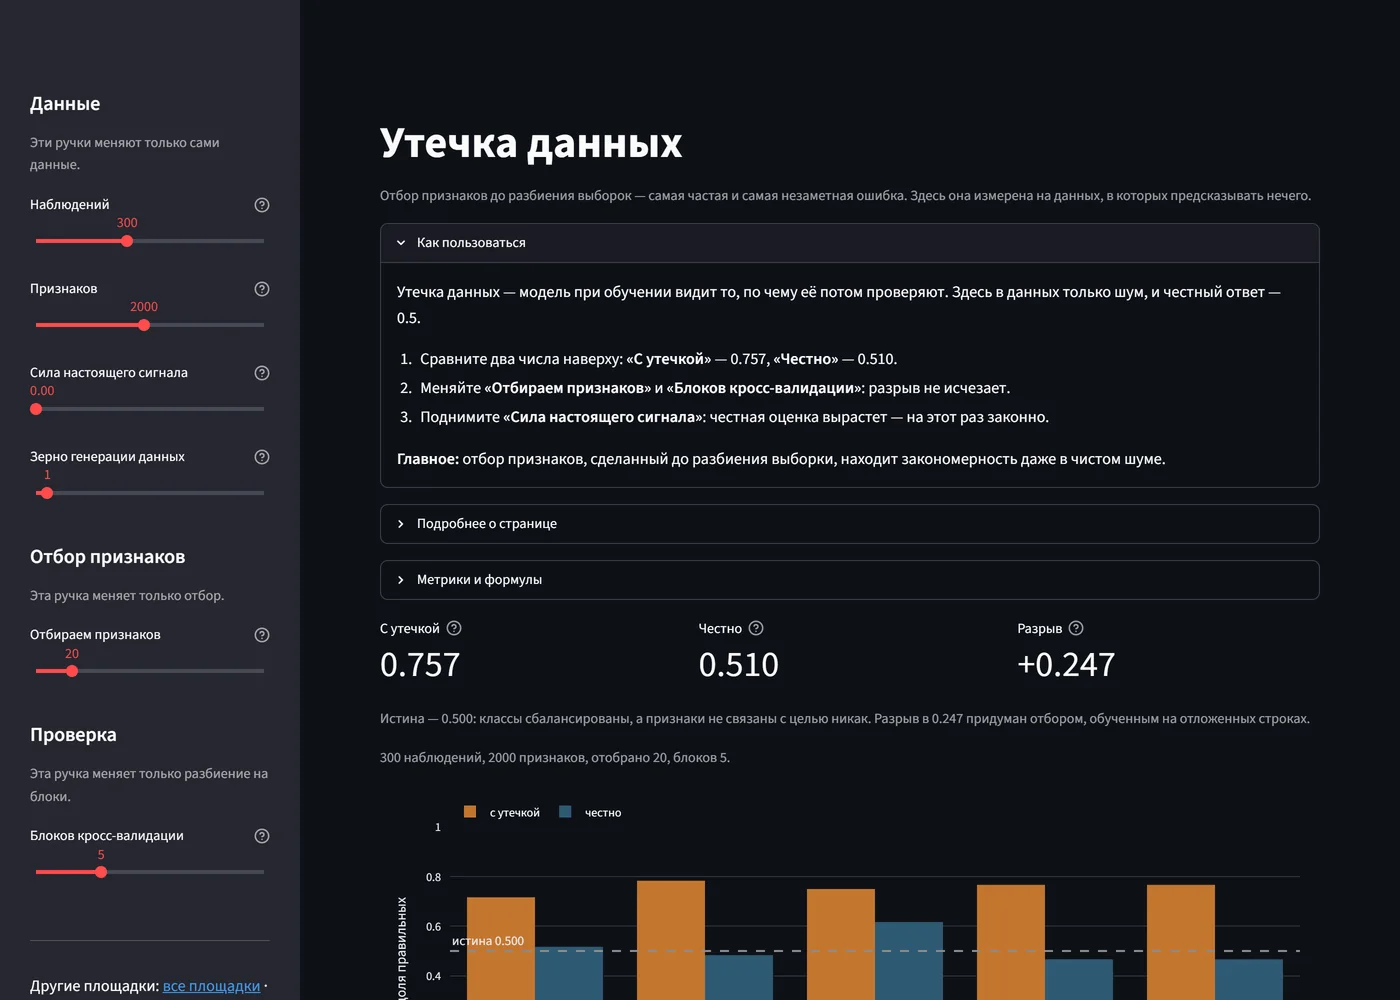
- Утечка данных. Признаки — чистый шум, честный ответ — 0.5. Отбор признаков до разбиения выборки даёт оценку 0.757, отбор внутри каждого блока кросс-валидации — 0.510. Из 2000 признаков 108 проходят порог p < 0.05, а случайность даёт около ста; поправку Бонферрони не выдерживает ни один.
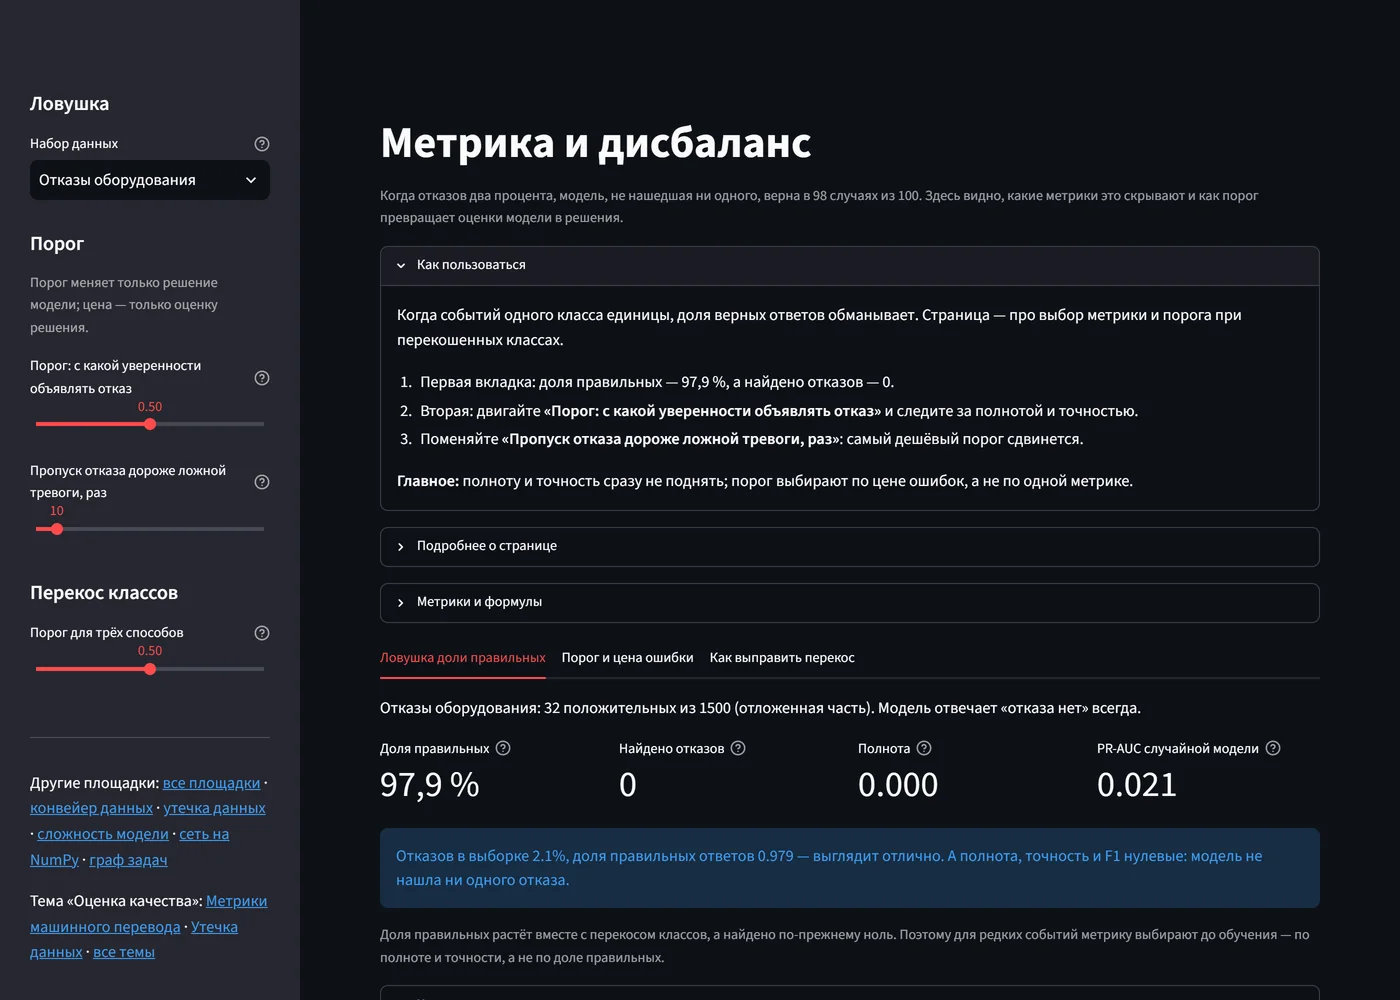
- Метрика и дисбаланс. Модель, которая всегда отвечает «отказа нет», права в 97,9 % случаев и не находит ни одного отказа. Если пропуск отказа в десять раз дороже ложной тревоги, самый дешёвый порог — 0.834. Порог меняет решение модели, цена ошибки — только оценку решения, и это две разные ручки.
- Сложность модели. Многочлен 17-й степени на обучающих точках ошибается на 0.023, а на новых — на 13.2, в 23 раза хуже ответа «среднее».
- Нейросеть на NumPy со сломанным по желанию обратным проходом. Сеть с забытой производной ReLU всё равно обучается до 0.887 против 0.947 — внешне это похоже на неудачные данные. Проверка градиента ловит ошибку, но не на всех весах: шесть весов второго слоя от производной ReLU не зависят, и проверка одной из них пропустила бы ошибку.
- Граф задач и отказы. Повторы, пропуски и непроверенная публикация видны в журнале запусков. Без ребра «оценка → публикация» конвейер выпускает модель, так и не прошедшую оценку.
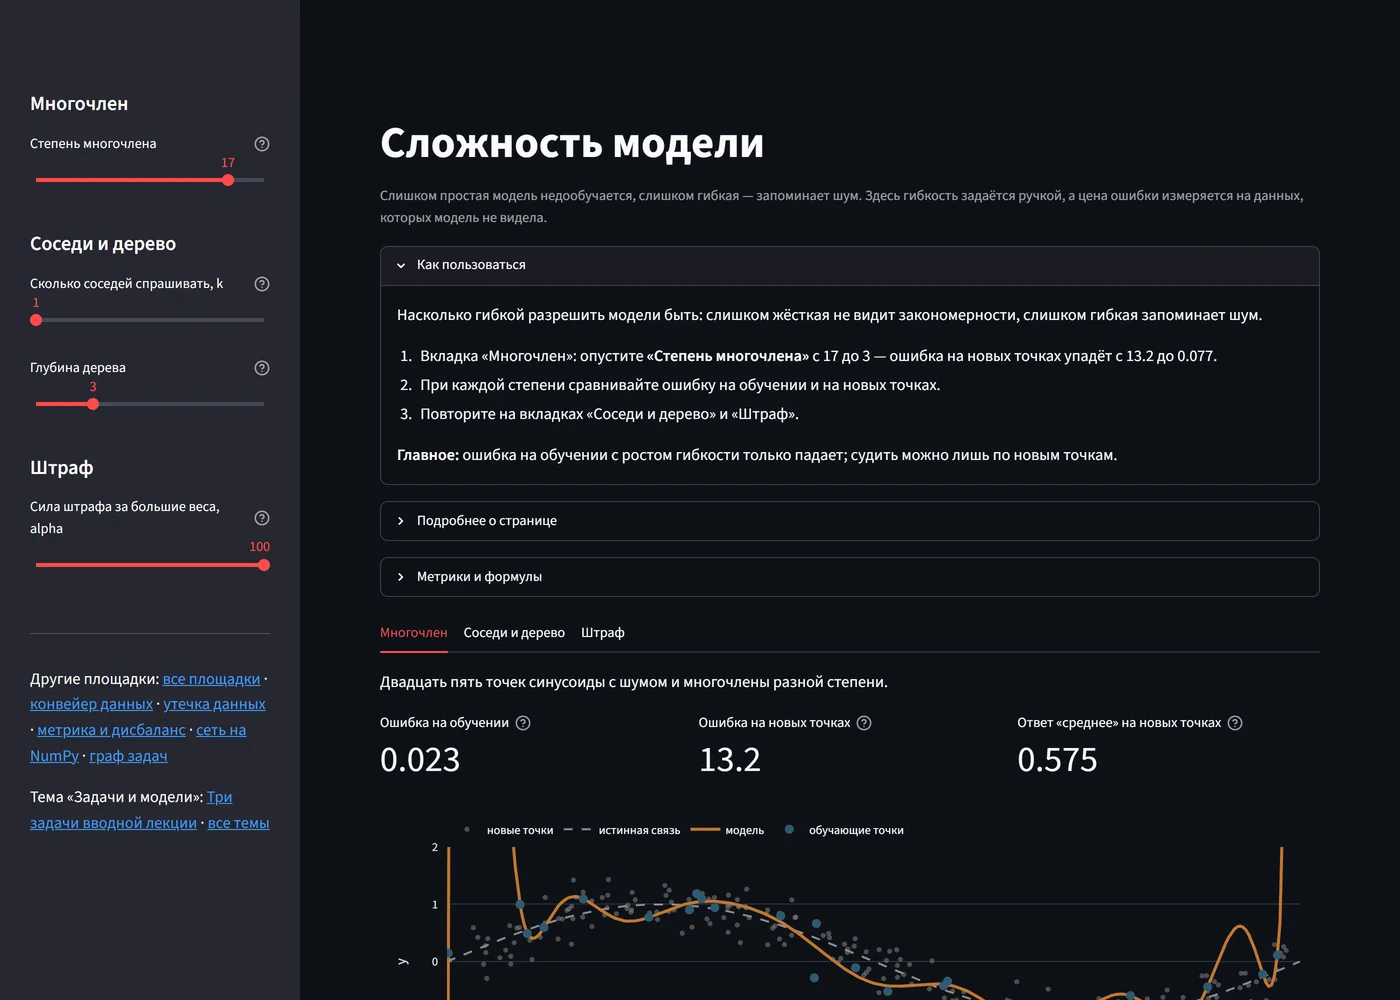
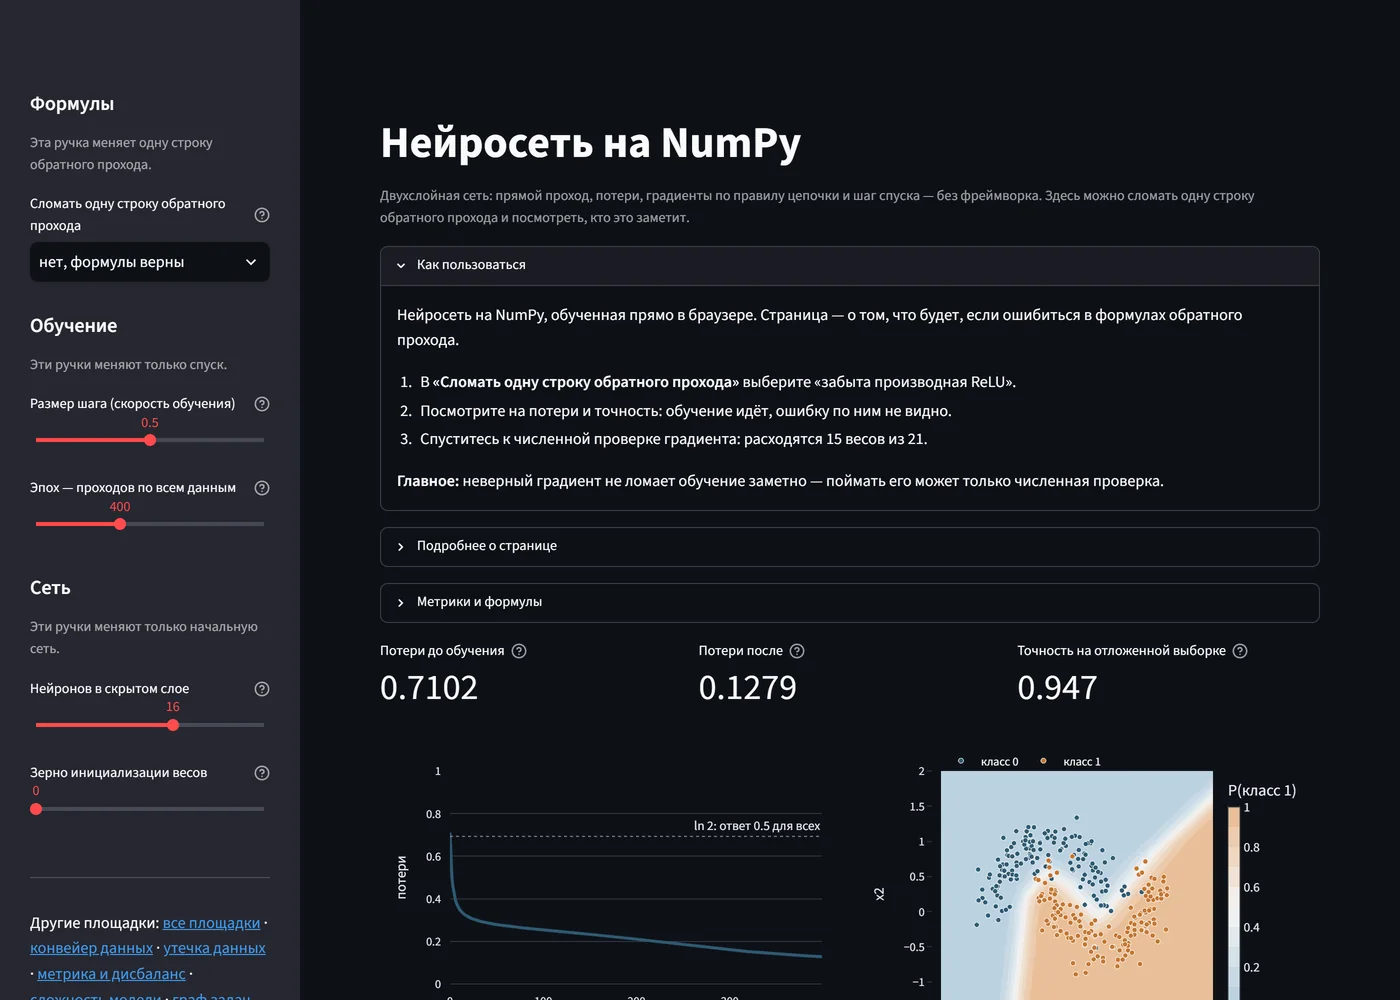
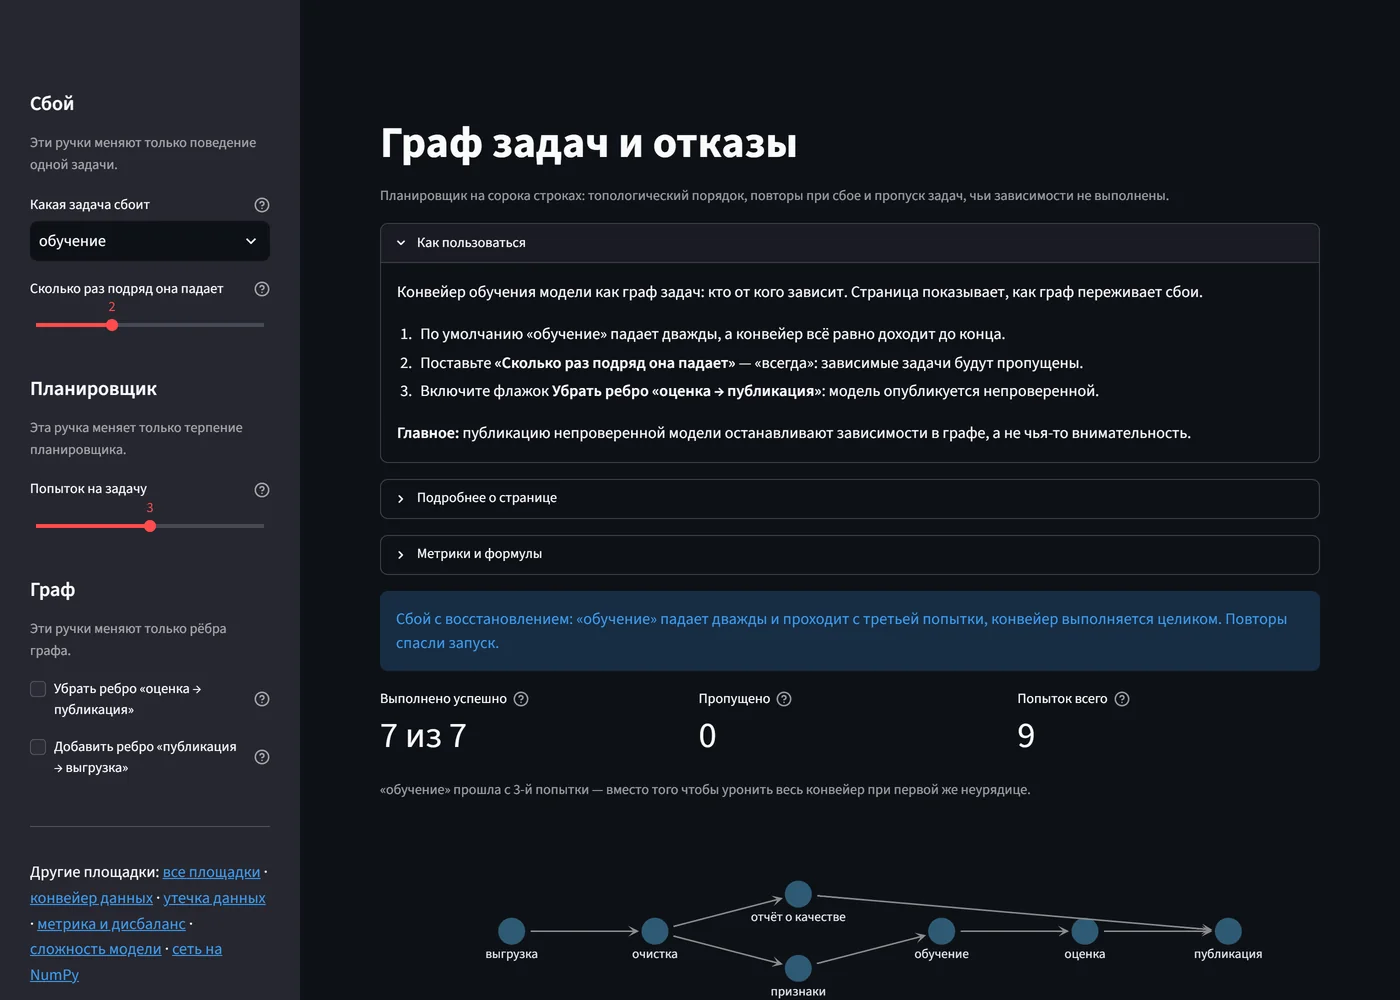
Тяжёлые зависимости площадки грузят только когда без них нельзя. Каждое лишнее колесо Python удлиняет первую загрузку в браузере, поэтому оценки моделей для «Метрики» и данные для «Нейросети» посчитаны заранее, и scikit-learn этим страницам не нужен.
Числа, которые зависят от версии
Первая версия площадок повторяла числа лекций до последнего знака, как и площадки первого курса. Повторяя, она перепроверила и сами лекции. В лекции об утечке сравнивались несимметричные конвейеры: утечная ветвь без масштабирования, честная — с ним. На вывод это не влияло, но сравнение должно отличаться только тем, что обсуждается. Лекция о регуляризации печатала только вырожденный случай Lasso, где обнулены все десять признаков, — это отказ от модели, а не отбор. Найденное исправлено в материалах, а не подогнано в площадках.
Затем тесты впервые запустились в CI, на чистом Linux и свежих пакетах, — до этого их проверяли на одной машине со старыми версиями. Нашлось три расхождения:
- scikit-learn 1.9 в линейной регрессии стал отбрасывать малые сингулярные числа. Для многочлена 17-й степени это работает как регуляризация: ошибка на обучении стала 0.043 вместо 0.023, а «взрыв» между точками, ради которого вкладка существует, пропал. Теперь площадка решает задачу наименьших квадратов сама и ведёт себя одинаково при любой версии;
- NumPy 2 считает синус и косинус иначе, чем 1.x, в последнем бите, и сохранённые данные «двух лун» совпадали с пересчитанными только до 2·10⁻¹⁶;
- отношение памяти списка и массива равно 4.5. Лекция округляла его до целого, и результат зависел от версии Python: «в 5 раз» на 3.12, где
sys.getsizeof(0)равен 28, и «в 4 раза» на 3.10, где он равен 24.
После этого связь площадок с лекциями ослаблена до общей темы: точное совпадение чисел оказалось хрупким и требовало править лекции ради площадок. Тесты проверяют теперь то, что площадка утверждает, как свойство: утечка завышает оценку, честная оценка близка к 0.5, ошибка на обучении падает с гибкостью модели, сломанный обратный проход ловит проверка градиента. Есть и правило «одна ручка — одна причина»: ни один элемент управления не должен менять две вещи сразу. Ползунок, который управляет и генерацией данных, и разбиением выборки, — именно та ошибка, после которой из опыта нельзя сделать вывод.
«Как пользоваться»
Последнее изменение касается всех тринадцати страниц. Каждая теперь начинается с короткого открытого блока: зачем страница, три шага, которые стоит попробовать, и главное, что нужно заметить. Шаги называют настоящие элементы управления, а все числа в них прочитаны со страницы в браузере, а не взяты из лекции. Тест держит каждый блок в пределах двух–четырёх шагов и девяноста слов. Длинное объяснение для тех, кто не слышал лекции, осталось ниже, свёрнутым.
Перечитывание страниц нашло и ошибки. Два утверждения в длинных объяснениях оказались неверными и исправлены. Две подсказки со знаками LaTeX были записаны обычными строками Python, и \alpha с \varepsilon доходили до страницы как управляющие символы — звонок и вертикальная табуляция. А площадка градиентного спуска при шаге 1 сообщала «Сошлось за 1 итерацию» с ошибкой, застывшей на начальных 43.95: пакетный спуск перепрыгивал минимум и каждый раз попадал на ту же высоту, и потери переставали меняться. Теперь сходимость требует, чтобы перестали двигаться и веса, а прогон, закончившийся там же, где начался, сообщает, перескакивает ли шаг или ползёт.
Выводы
- Площадка, которая повторяет числа лекции, заодно проверяет лекцию. Найденное стоит исправлять в источнике, а не подгонять копию.
- Точное совпадение чисел зависит от версий библиотек и платформы. Проверка на нескольких версиях в CI показала это раньше студентов.
- Учебное утверждение надёжнее проверять как свойство: «утечка завышает оценку» переживает обновление scikit-learn, а «0.023» — нет.
- Если вывод опыта держится на поведении библиотеки, это поведение лучше закрепить своим кодом: многочлен, решённый своими наименьшими квадратами, переобучается при любой версии.
- Короткая инструкция на каждой странице — тоже код, который стоит проверять: числа в ней прочитаны в браузере, а длина ограничена тестом.
Доступность
Площадки обоих курсов открыты и работают в браузере без установки: Python исполняется на стороне студента через stlite. Исходный код открыт под лицензией MIT.
- Каталог по темам: konkin-nikita.ru/gd_learn/topics
- Площадки второго курса: konkin-nikita.ru/gd_learn/ml-practice
- Исходный код: github.com/nikita-konkin/gd_learn
Теги
Другие обновления по проекту
Площадки по ML: тёмная тема для Streamlit без перезапуска и ошибка, которую нашла подсветка
Переключатель темы на всех страницах сайта, который перекрашивает площадки на Streamlit без перезапуска Python; объяснение данных на площадке об утечке, где подсветка настоящих ...
Семь playground'ов курса машинного обучения: лабораторные, которые можно крутить в браузере
Тренажёр градиентного спуска вырос в набор интерактивных приложений для курса «Основы машинного обучения» магистратуры лингвистики. Каждое повторяет лабораторную или блок лекции...