Площадки по ML: тёмная тема для Streamlit без перезапуска и ошибка, которую нашла подсветка
Переключатель темы на всех страницах сайта, который перекрашивает площадки на Streamlit без перезапуска Python; объяснение данных на площадке об утечке, где подсветка настоящих признаков нашла ошибку в документации; расшифровка признаков diabetes и замер скорости, который показывал «×inf быстрее», потому что браузер огрубляет часы.
После выхода площадок второго курса — «Основы программирования систем ИИ на языке Python» — пришли четыре изменения. Два из них добавляют объяснения, одно исправляет замер, который в браузере давал бесконечность, а одно касается всего сайта.
Тёмная тема без перезапуска Python
В правом верхнем углу каталогов и площадок появилась кнопка темы. Выбор общий для всего сайта и хранится в браузере; пока читатель ничего не выбрал, действует системная тема.
Сложность была в площадках. Они работают на stlite — Streamlit, запущенном в браузере через Pyodide, — и Streamlit выбирает тему сам, по системной настройке prefers-color-scheme. Перезапускать Python ради смены темы долго: первая загрузка страницы скачивает рантайм и занимает до минуты. Решение в том, чтобы ответить Streamlit на тот же запрос: переключатель подменяет ответ на prefers-color-scheme выбором читателя, и площадка перекрашивается сама.
Цвета шаблонов теперь привязаны к атрибуту data-theme, а не к системной теме. Тесты проверяют, что вставка с переключателем есть на каждой странице и стоит раньше загрузки stlite. Проверено и на ширине 375 пикселей: ни одна из 13 площадок не прокручивается по горизонтали, а графики помещаются в экран.
Утечка данных: что за данные и что отобралось
Площадка об утечке данных показывает, как отбор признаков до разбиения выборки находит закономерность в чистом шуме. Раньше она начиналась сразу с чисел. Теперь перед ними стоит блок «Данные и задача»: что за таблица, что предсказывается, что такое сигнал и где именно происходит утечка.
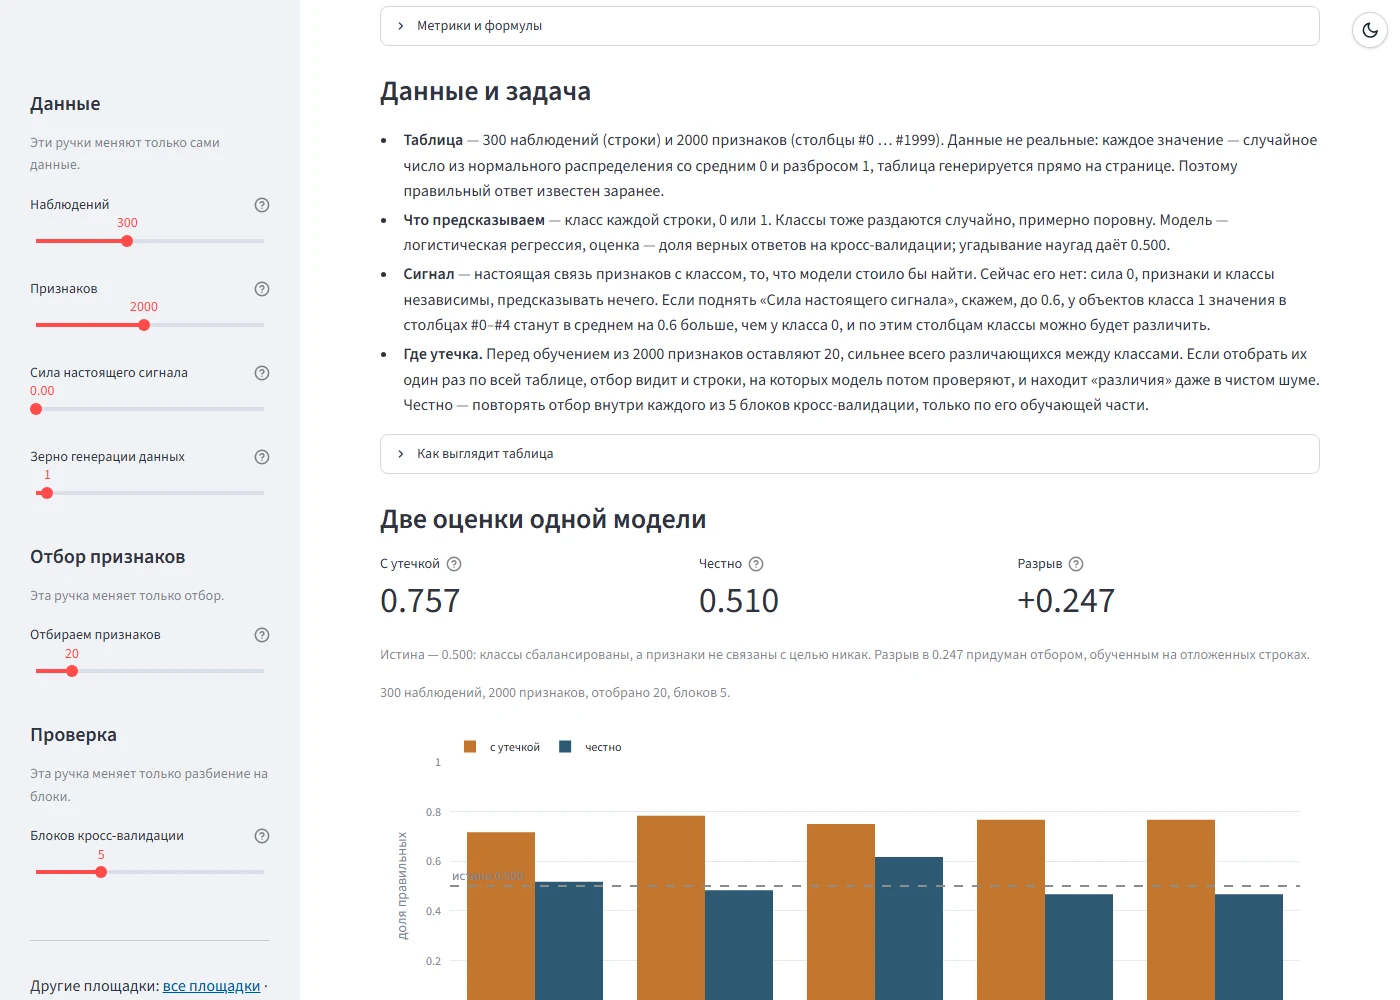
Таблица — 300 строк и 2000 столбцов случайных чисел, классы тоже раздаются случайно, поэтому честный ответ известен заранее: 0,5. Ползунок «Сила настоящего сигнала» сдвигает среднее у класса 1 в столбцах #0–#4, и тогда предсказывать становится что.
Раздел «Что именно отобралось» теперь объясняет свой график. Отбор по всей таблице выбрал 20 столбцов; затем он повторяется пять раз, как в честной ветви, — каждый раз только по обучающей части одного блока. Высота столбика — в скольких блоках признак отобран снова. Настоящие признаки выделены цветом.
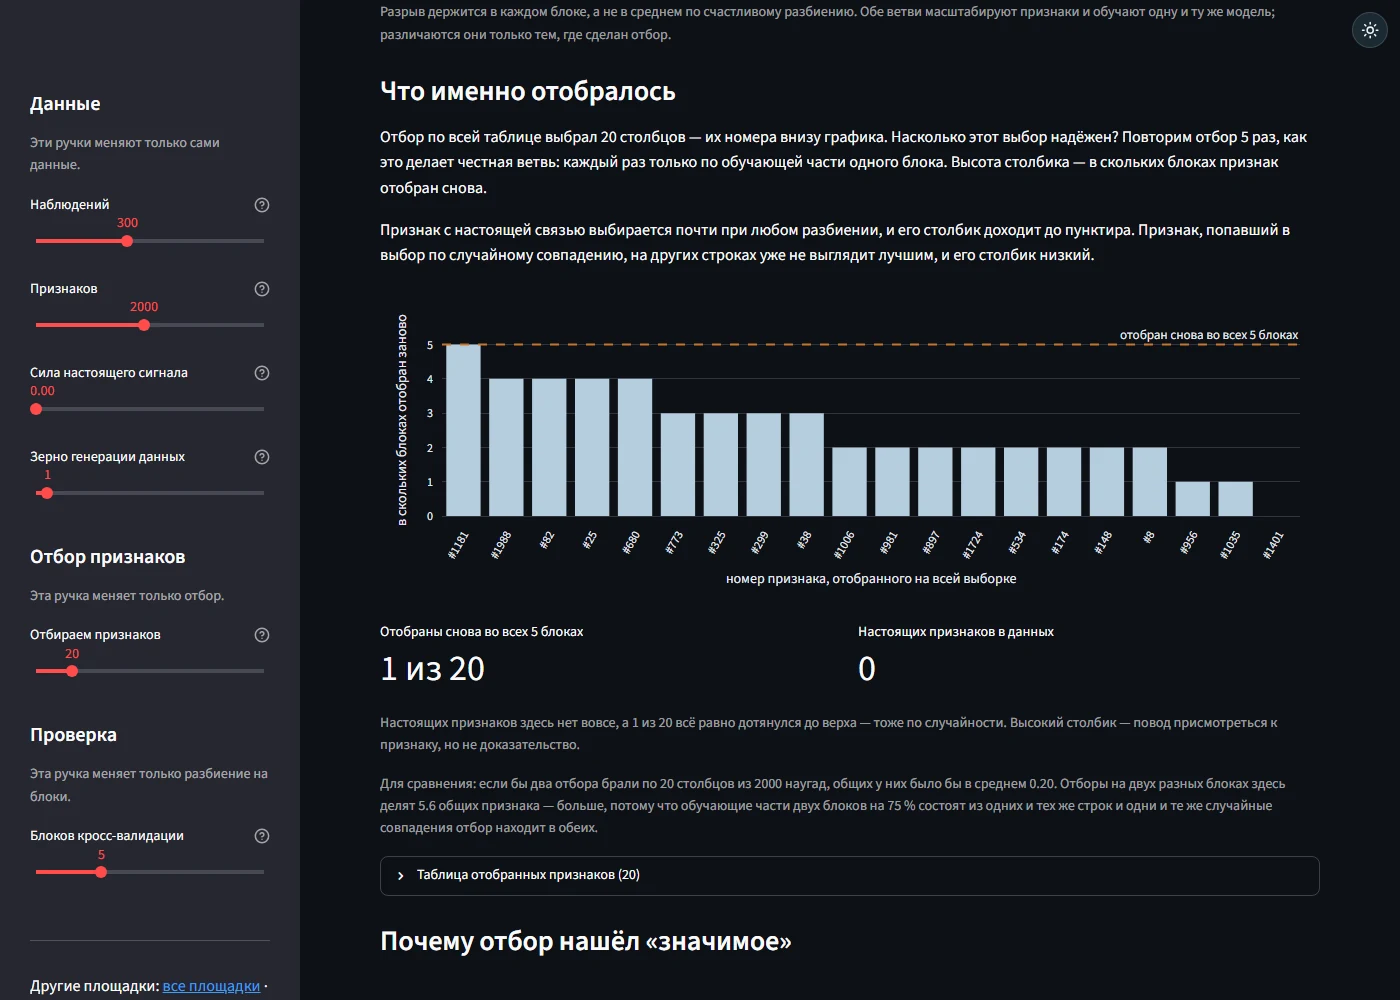
Подсветка сразу нашла ошибку в документации курса. Там было сказано, что при силе сигнала 0,6 до верха дойдут пять признаков и это будут именно те пять столбцов, в которые положен сигнал. На деле один из пяти шумовой, #1181, а настоящий признак #0 отобран снова лишь в четырёх блоках из пяти; все пять настоящих доходят до верха только при 0,8 — и вместе с ними тот же #1181. Документация исправлена: высота столбика — подсказка, а не доказательство. Тот же #1181 виден и на снимке: при нулевом сигнале он единственный дотягивается до верха — по чистой случайности.
Сложность модели: что означают признаки diabetes
На площадке о сложности модели вкладка «Штраф» показывает, как Ridge и Lasso сжимают веса десяти признаков набора diabetes. Под графиком весов появился блок «Что означают признаки»: что измерено в каждом столбце, веса Ridge и Lasso при выбранной силе штрафа и как читать вес стандартизованного признака.
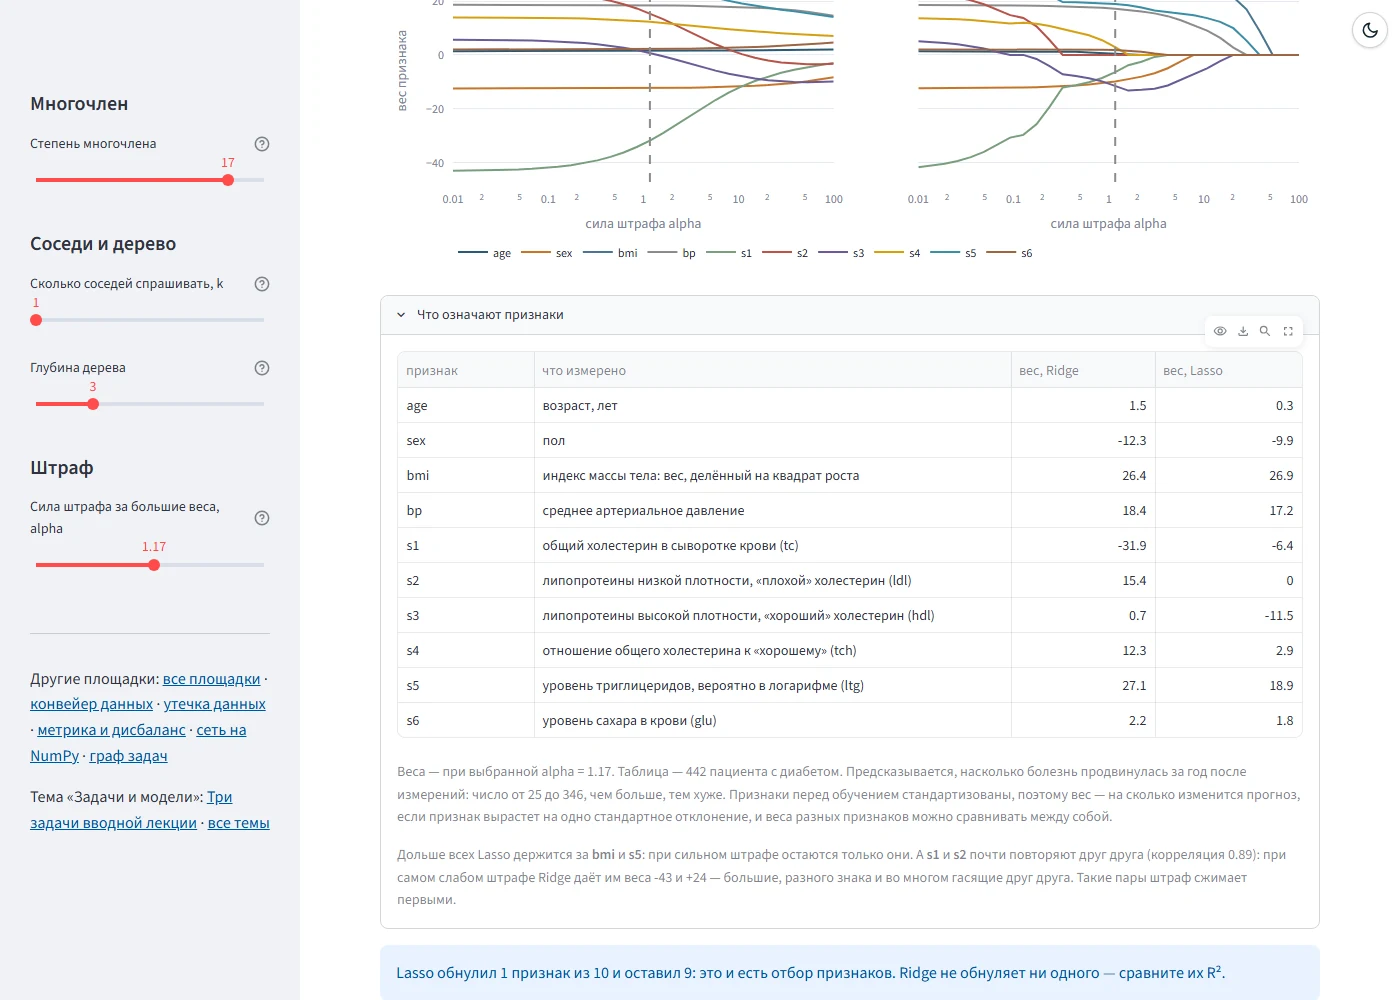
Предсказывается, насколько болезнь продвинулась за год после измерений, — число от 25 до 346. Признаки перед обучением стандартизованы, поэтому вес — это то, на сколько изменится прогноз, если признак вырастет на одно стандартное отклонение, и веса разных признаков можно сравнивать между собой.
Два вывода в блоке не вписаны текстом, а вычисляются из данных: какие признаки Lasso держит дольше всех (здесь bmi и s5) и какая пара почти повторяет друг друга. Это s1 и s2 — общий холестерин и «плохой» холестерин с корреляцией 0,89. При самом слабом штрафе Ridge даёт им веса −43 и +24 — большие, разного знака и во многом гасящие друг друга. Такие пары штраф сжимает первыми.
Замер скорости и огрублённые часы
На площадке о подготовке данных вкладка «Векторизация и память» сравнивает три способа посчитать сумму квадратов: генератор Python и два способа в NumPy. Замер идёт прямо в браузере, и при малом числе элементов он показывал «0.0 мс» и «×inf быстрее».
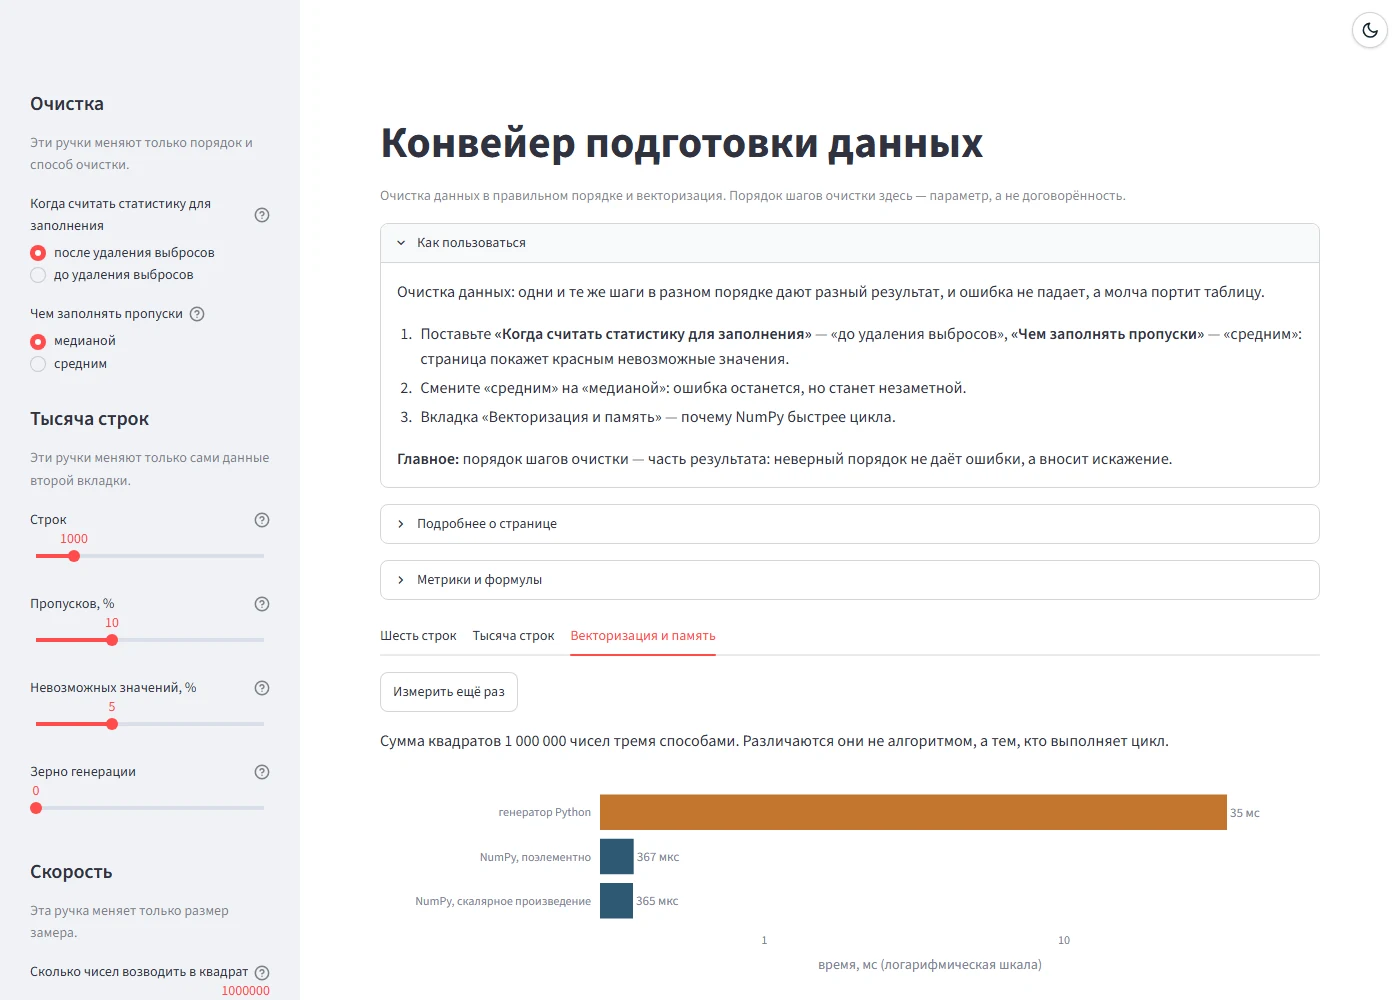
Причина — в часах. Чтобы по времени нельзя было читать память через атаки по времени, браузеры огрубляют performance.now(), а через неё и время, которое видит Python: до 0,1 мс в Chrome и до 1 мс в Firefox и Safari. Сумма квадратов десяти тысяч чисел в NumPy укладывается в один такт этих часов, и замер по одному вызову давал ноль. Теперь, как в timeit, каждый замер — серия вызовов длиной не меньше 20 мс: двадцать тактов самых грубых часов держат ошибку округления в пределах 5 %. Число вызовов подбирается из ряда 1, 2, 5, 10, 20, 50…, а время выводится в мкс, мс или с.
Выводы
- Тему приложения, которое само следит за
prefers-color-scheme, можно переключать, подменив ответ на этот запрос, — без перезапуска и без вмешательства в код приложения. - Объяснение на графике — это ещё и проверка: подсветка настоящих признаков сразу показала ошибку в тексте, написанном без неё.
- Выводы в пояснениях лучше вычислять из данных, а не вписывать: тогда они не разойдутся с графиком при другой настройке.
- Замер времени в браузере должен учитывать огрублённые часы: серия вызовов вместо одного.
Доступность
Площадки открываются в браузере без установки, исходный код открыт.
- Площадки: konkin-nikita.ru/gd_learn/topics
- Исходный код: github.com/nikita-konkin/gd_learn
Теги
Другие обновления по проекту
ML Playgrounds: второй курс, каталог по темам и числа, которые зависят от версии библиотеки
К площадкам курса машинного обучения для магистратуры добавились шесть площадок бакалаврского курса программирования систем ИИ на Python, а сайт стал общим каталогом по темам. Ч...
Семь playground'ов курса машинного обучения: лабораторные, которые можно крутить в браузере
Тренажёр градиентного спуска вырос в набор интерактивных приложений для курса «Основы машинного обучения» магистратуры лингвистики. Каждое повторяет лабораторную или блок лекции...