Семь playground'ов курса машинного обучения: лабораторные, которые можно крутить в браузере
Тренажёр градиентного спуска вырос в набор интерактивных приложений для курса «Основы машинного обучения» магистратуры лингвистики. Каждое повторяет лабораторную или блок лекции на одном корпусе, воспроизводит её числа — а тесты проверяют это на каждом прогоне — и целиком работает в браузере, без сервера.
Проект начинался как тренажёр градиентного спуска: синтетические данные, три вида спуска, анимация шагов и поверхность функции потерь. За полторы недели он вырос в набор из семи интерактивных приложений. Шесть новых сделаны для курса «Основы машинного обучения» магистратуры лингвистики: каждое повторяет лабораторную работу или блок лекции, и все работают на одном и том же корпусе — 160 сегментах локализации программного интерфейса.
Лабораторная в ноутбуке показывает результат. Playground позволяет его крутить: поменять признаки, порог или порядок модели — и сразу увидеть, что произошло с числами.
Числа, которые совпадают с лабораторной
Главное требование ко всем playground’ам — воспроизводить числа своей лабораторной работы. Иначе студент увидит в приложении одно, в ноутбуке другое, и доверие к обоим пропадёт. Поэтому совпадение не декларируется, а проверяется тестами на каждом прогоне CI: средний BLEU по корпусу — 0.458 против 0.46 в работе, таблица сравнения признаков — до третьего знака, девять из тринадцати запросов к памяти переводов, на которых меры выбрали один сегмент, — как в работе.
Совпадать пришлось даже в округлении. Наивный Байес на символьных n-граммах даёт ровно 98/160 = 0.6125. Ноутбук печатает 0.612, потому что округляет половину к чётному; форматная строка напечатала бы 0.613. Все playground’ы округляют так же, как ноутбуки, — иначе студент увидел бы расхождение в последнем знаке и справедливо спросил бы, какое число верное.
Воспроизведение попутно проверило и сами материалы курса. В одном из них для кластеризации указано значение 0.024 и рост «примерно в семь раз», тогда как ноутбук при выполнении печатает 0.079 — рост в 2,2 раза. Playground воспроизводит ноутбук.
Что метрика не видит
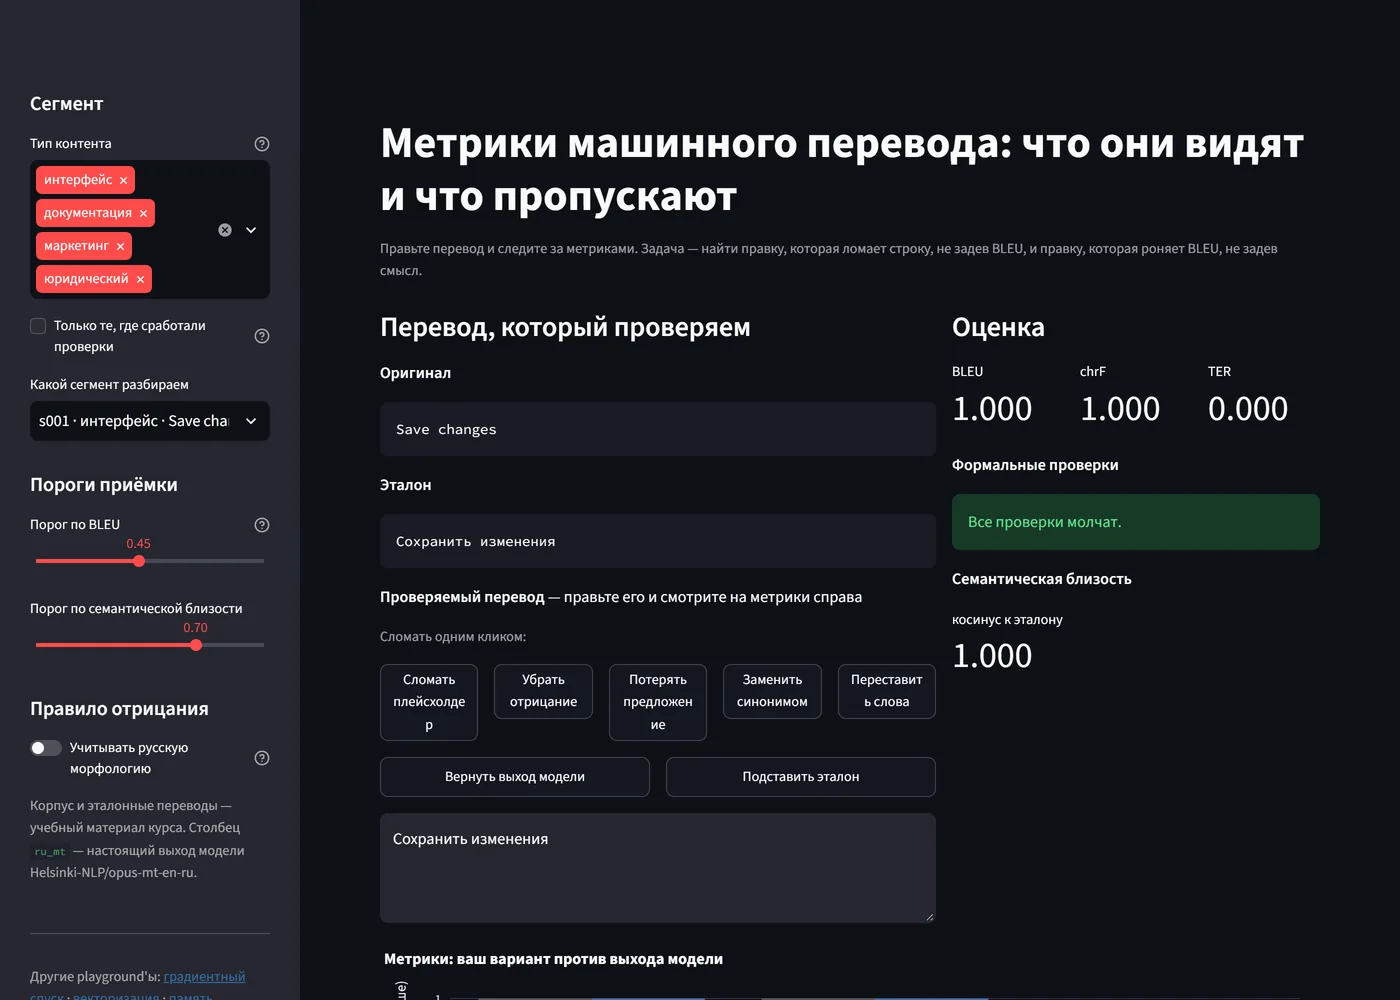
Playground метрик машинного перевода построен вокруг двух правок, которые студент должен найти. Первая ломает строку, не задев метрику: если в сегменте подставить эталон и испортить плейсхолдер, {name} → (name}, BLEU останется равен 1.000. Токенизация отбрасывает пунктуацию, поэтому метрика этой поломки не видит в принципе, а строка интерфейса не соберётся. Вторая правка обратная: замена слова синонимом снижает BLEU на 0.4 при полностью сохранном смысле.
Воспроизведение нашло и слепую зону самой проверки. Правило поиска отрицания из лабораторной задано списком словоформ и даёт на этом корпусе две ложные тревоги: «Невозможно подключиться» (отрицание сращено с основой) и «Результаты отсутствуют» (в списке только форма «отсутствует»). Переключатель в боковой панели заменяет правило морфологическим: срабатываний становится шесть вместо восьми, а настоящая потеря предложения остаётся на месте. Правило лабораторной остаётся по умолчанию, чтобы её числа воспроизводились, — а вывод для отчёта готов: у средства против слепой зоны метрики есть своя слепая зона.
Качество и списывание — одна ось
Демонстрация языковой модели в лабораторной требовала TensorFlow, видеокарту и Colab и обучалась на английском Шекспире — единственная работа, выпадавшая из общего корпуса. Её заменила символьная n-граммная модель, которая обучается прямо в браузере на том же русском корпусе за миллисекунды. Модель — словарь счётчиков, её можно распечатать и прочитать глазами.
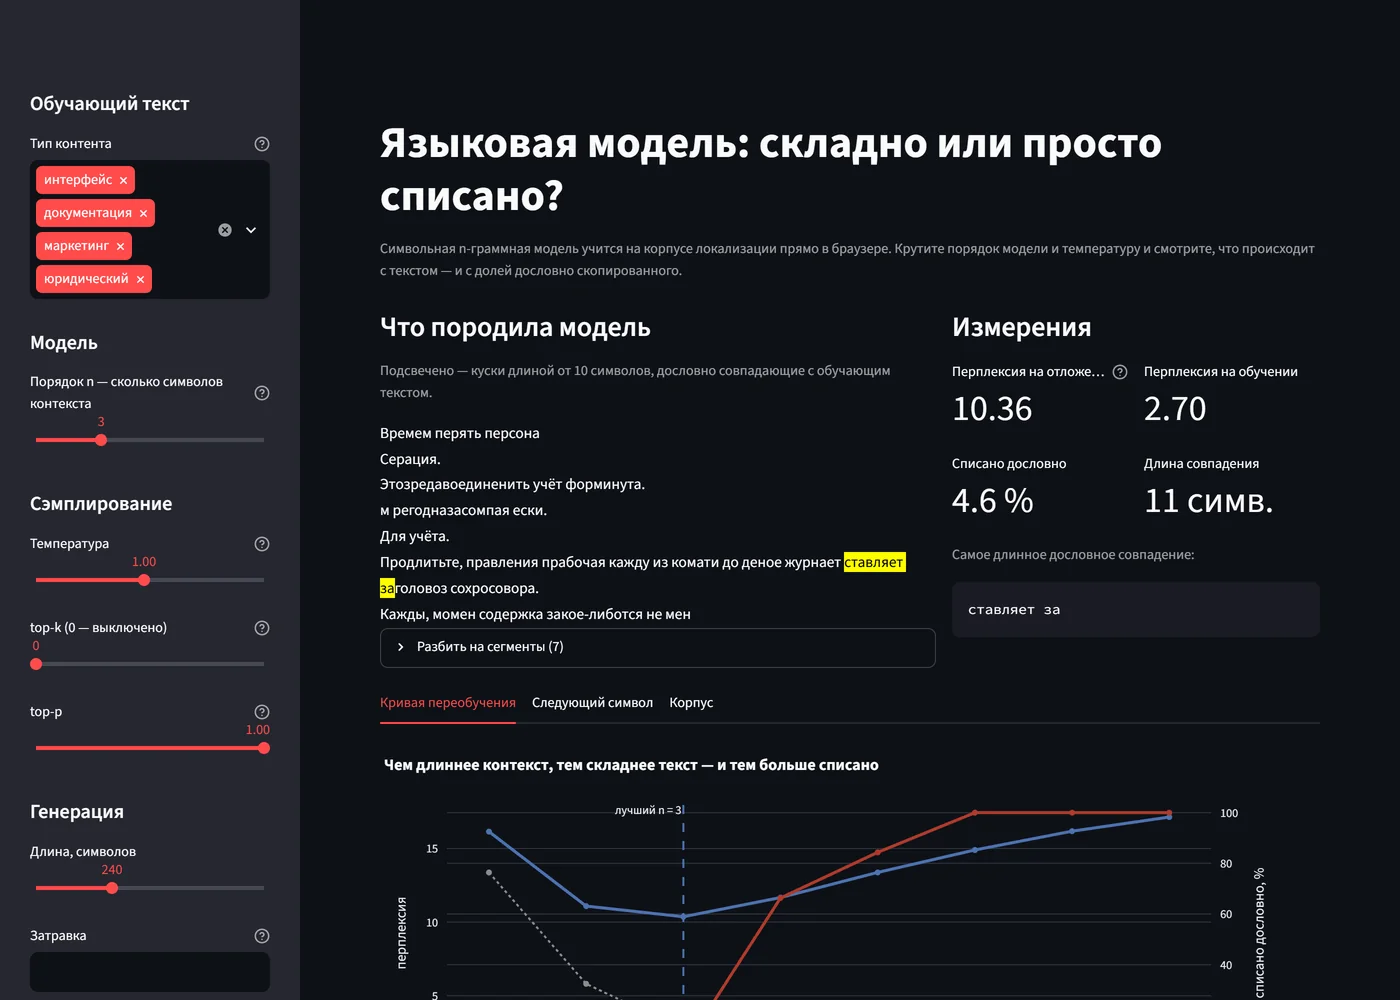
Ради одной закономерности она здесь и стоит. Ползунок порядка модели меняет сразу три величины:
| порядок n | перплексия на отложенных | списано дословно |
|---|---|---|
| 1 | 16.14 | 0.0 % |
| 3 | 10.36 — минимум | 3.7 % |
| 5 | 13.37 | 93.7 % |
| 8 | 17.13 | 100.0 % |
При n = 1 текст оригинален и бессмыслен. При n = 8 он читается как настоящая документация — и подсвечен целиком, потому что это дословные куски корпуса. Перплексия на отложенных текстах разворачивается вверх после n = 3: модель перестаёт обобщать и начинает запоминать ровно там, где текст начинает выглядеть прилично. Вывод не нужно принимать на веру — совпадения от десяти символов подсвечены прямо в порождённом тексте.
Одна деталь найдена только в браузере: ползунок зерна сначала управлял и разбиением на обучающую и отложенную части, и генерацией. Смена зерна ради другого образца текста переставляла данные и сдвигала кривую переобучения. Теперь разбиение закреплено, а тест проверяет, что измерения стоят на месте, пока меняется текст.
Признаки решают больше, чем модель
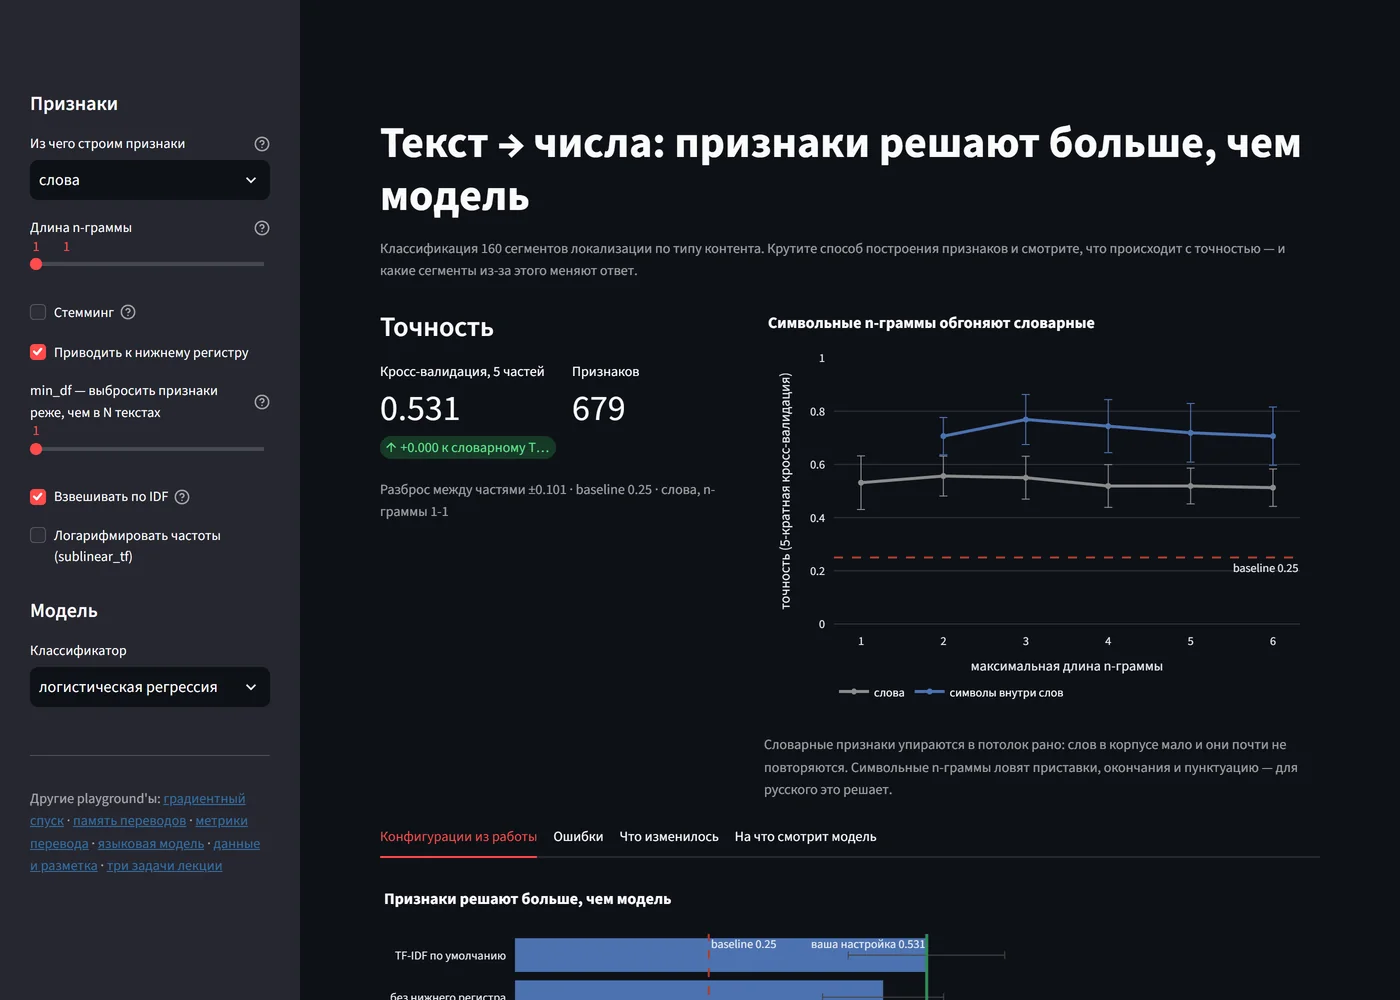
Playground векторизации — интерактивная версия первой лабораторной: классификация сегментов по типу контента. Главный график показывает точность как функцию длины n-граммы. Словарные признаки упираются в потолок около 0.55 — слов в корпусе мало, и они почти не повторяются. Символьные проходят выше 0.74, потому что ловят приставки, окончания и пунктуацию; для русского это решает больше, чем замена классификатора.
Вкладка «Что изменилось» показывает то, что средняя точность прячет: при смене признаков часть сегментов исправляется, а часть портится, и это разные сегменты. А если разброс между частями кросс-валидации больше, чем разница с эталонной настройкой, интерфейс сам предупреждает: на 160 сегментах такую разницу нельзя выдавать за улучшение.
Где меры похожести расходятся
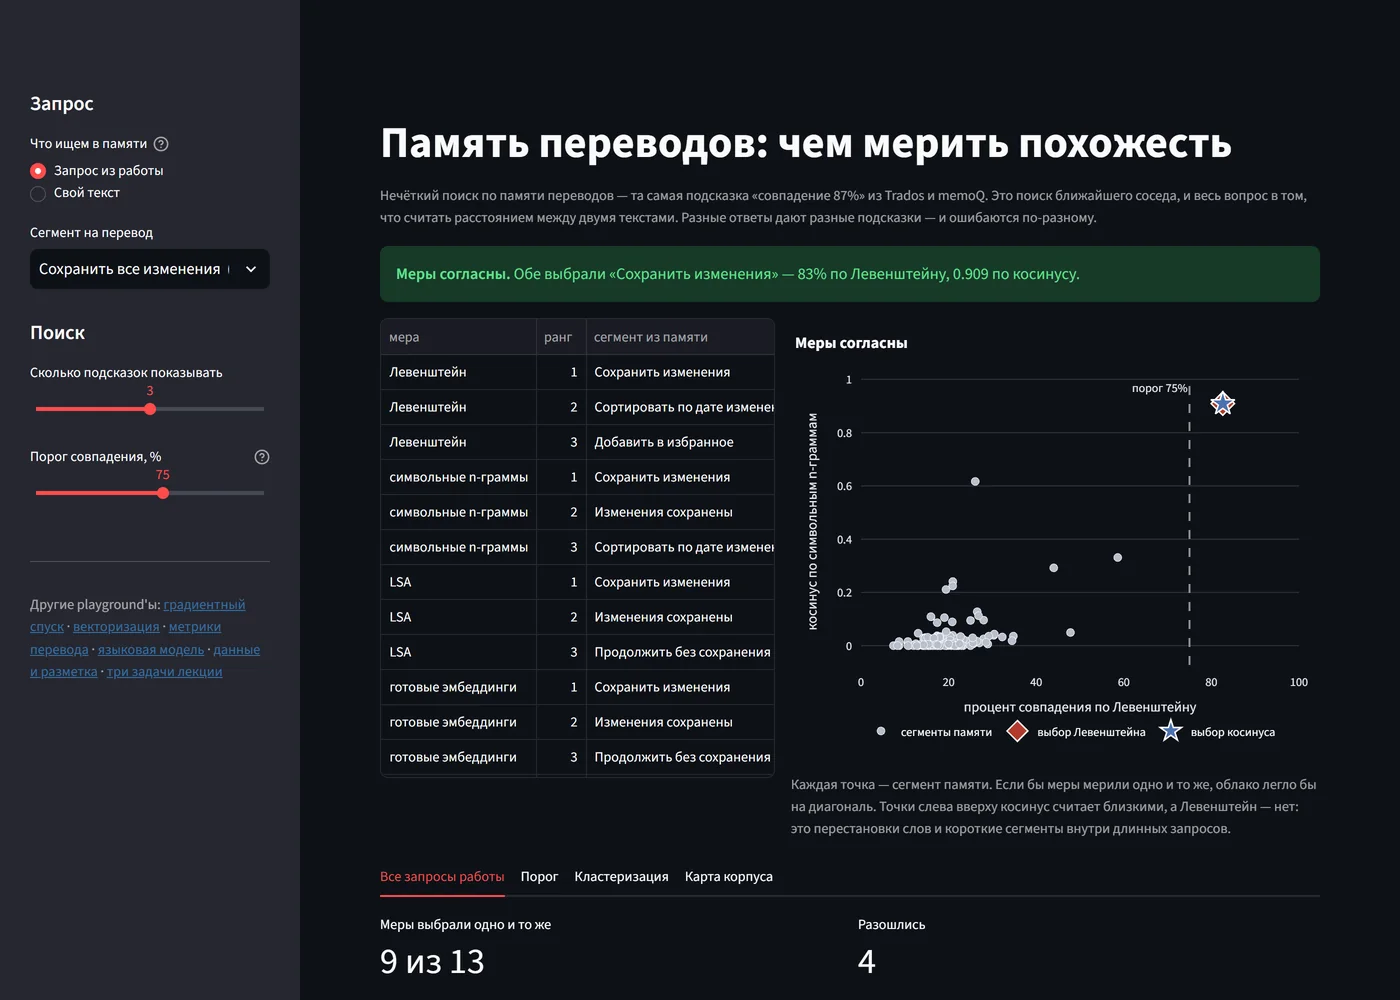
Playground памяти переводов сравнивает четыре меры близости — расстояние Левенштейна, символьные n-граммы, LSA и готовые эмбеддинги — на одном запросе. Главный график кладёт все сегменты на плоскость «процент по Левенштейну × косинус». Если бы меры мерили одно и то же, облако легло бы на диагональ; вместо этого выбор каждой меры оказывается в своём углу. Расхождения бывают трёх видов: переставленные слова, короткий сегмент внутри длинного запроса и номинализация, где обе подсказки разумны и выбирать должен человек.
Здесь же честно разобрана невоспроизводимость. Кластеризация KMeans приходит к другому локальному минимуму на другой реализации BLAS, а разброс результата по начальным приближениям шире разницы между представлениями. Поэтому тесты проверяют утверждения работы — согласие кластеров с типами контента близко к нулю, эмбеддинги его сдвигают, но задачу не решают, — а не третий знак, который нельзя переносить с машины на машину.
Данные и разметка
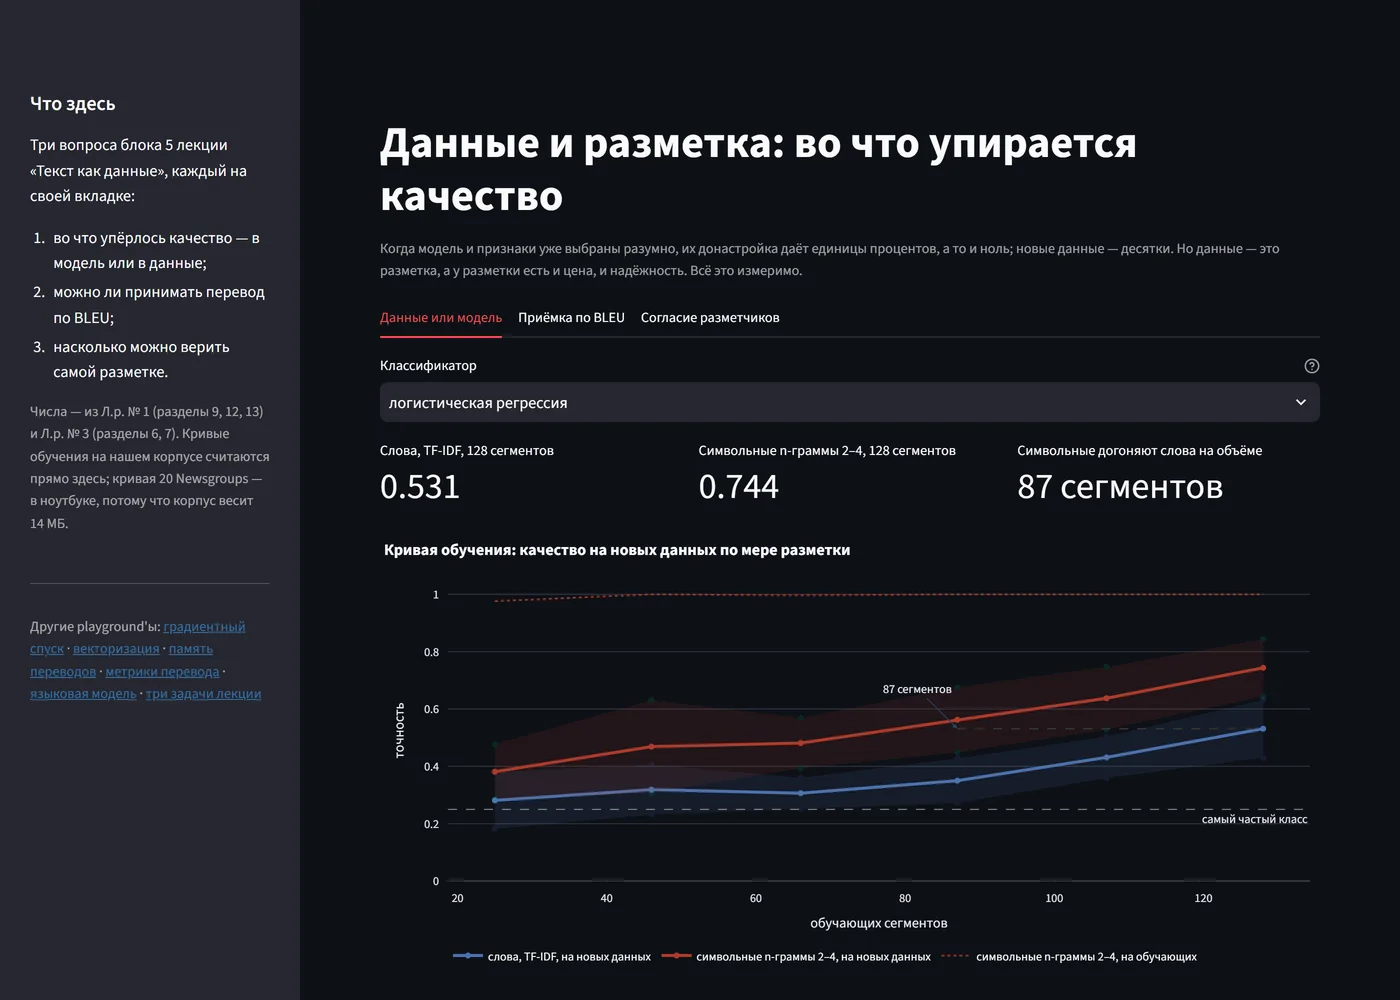
Шестой playground отвечает на вопросы о самих данных. Символьные n-граммы на 87 сегментах догоняют слова, обученные на всех 128: удачная идея о признаках экономит 41 сегмент разметки. Порога BLEU, при котором приёмка перевода без проверки не ошибается, нет: сегмент с критической ошибкой получает 0.630, безупречный — 0.156. А два разметчика, которые вообще не согласны, при 80 % сегментов без ошибок совпадают в 65 % случаев — поэтому согласие меряют каппой, которая такие совпадения вычитает.
Ключ преподавателя к разметке ошибок студентам не выдаётся, и playground его не публикует: вкладки используют только десять сегментов, которые работа размечает сама, а тест проверяет, что в данных лежат ровно четыре известных файла.
Три задачи вводной лекции
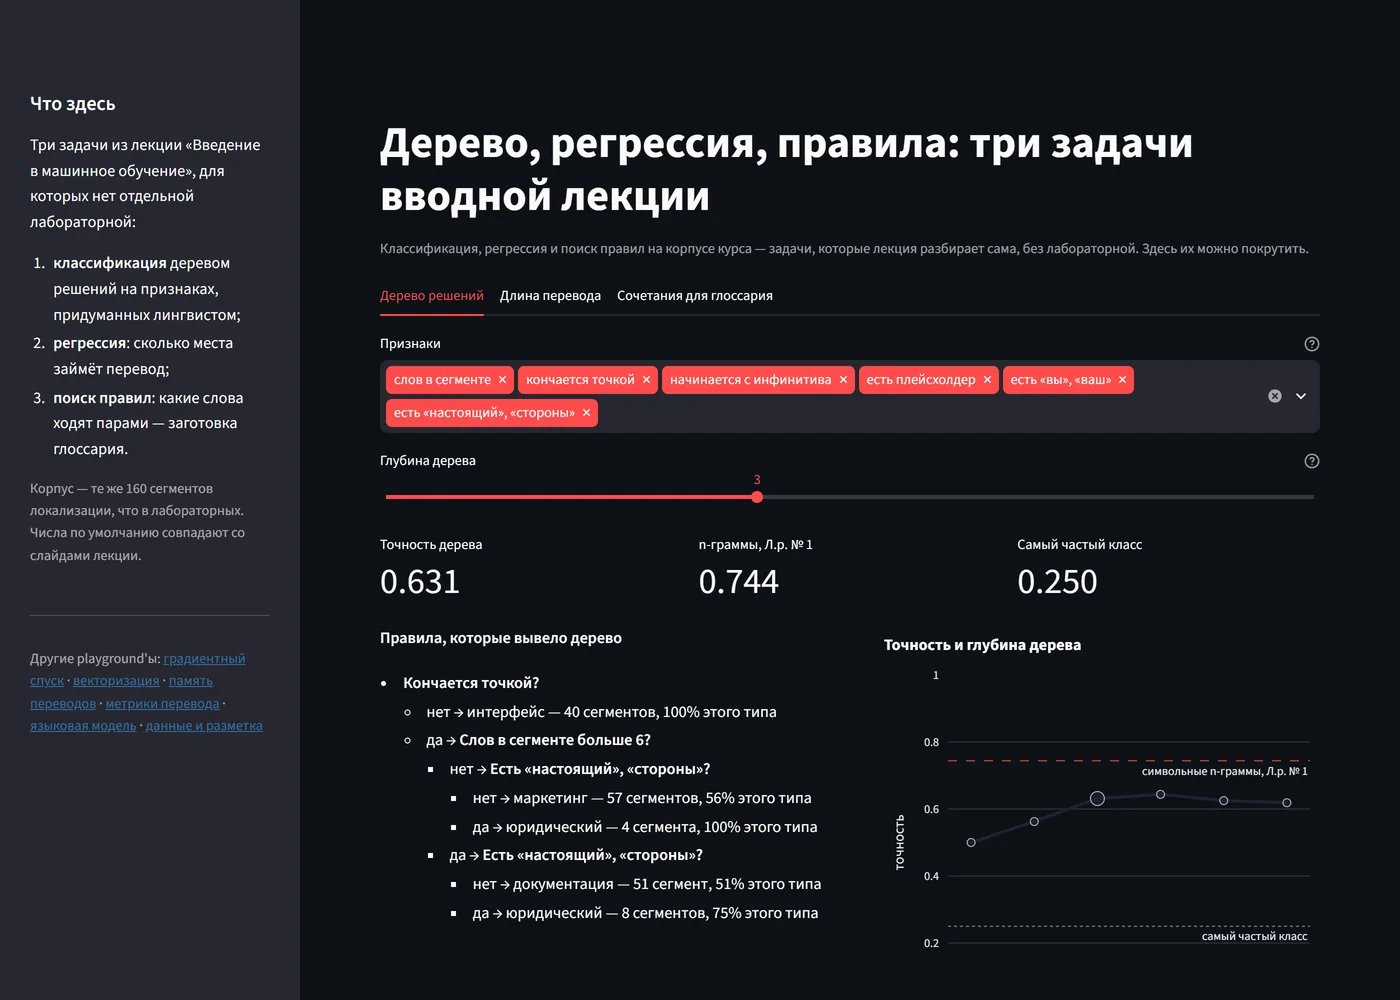
Последний playground оживляет задачи, которые на слайдах вводной лекции видны одной картинкой. Дерево решений глубины 3 на шести признаках, которые придумал бы лингвист, даёт 0.631 против 0.744 у символьных n-грамм: правила читаются, но проигрывают. Без признака «кончается точкой» точность падает до 0.506. Регрессия длины перевода показывает, что «+10 %» со слайда — среднее отношений по сегментам, а по сумме символов перевод длиннее всего на 6,6 %.
Здесь нашлась ошибка, которую не видно глазами. Под pandas 3 строки хранятся в pyarrow, и граница слова \b в его регулярных выражениях знает только латиницу: рядом с кириллицей она не находится, и два признака из шести молча обнуляются. Поэтому признаки считает модуль re, а тест держит это место.
Python без сервера
GitHub Pages отдаёт только статические файлы, а Streamlit обычно требует Python-сервер. Поэтому сайт собирается через stlite: CPython (Pyodide) и Streamlit запускаются прямо в браузере через WebAssembly, и весь расчёт идёт на стороне студента. Исходники копируются в сборку без изменений, так что развёрнутое приложение не может разойтись с репозиторием.
Цена браузера — ограничения, которые приходится обходить. Настоящий pyarrow в сборку не помещается, и stlite подсовывает заглушку, у которой нет части классов. scikit-learn обращается к ним при разборе любых входных данных, так что без заплатки в браузере падал бы любой его вызов. Заплатка дописывает недостающие имена пустыми классами, у которых не бывает экземпляров, и isinstance честно возвращает False. Многоязычный энкодер для семантической близости в браузер тоже не помещается — поэтому эта мера посчитана заранее для исходных текстов, а для правленого руками интерфейс прямо сообщает, что её нет.
Выводы
- Интерактивная версия лабораторной полезна, только если воспроизводит её числа. Совпадение стоит проверять тестами, вплоть до правила округления.
- Воспроизведение — ещё и проверка исходных материалов: оно нашло расхождение в документации курса и ложные тревоги в правиле лабораторной.
- Лучший довод — видимый. Подсвеченный дословно списанный текст убеждает в переобучении надёжнее любой кривой.
- Если число не воспроизводится между машинами, проверять нужно утверждение, а не число.
- Статический хостинг снимает сервер, но переносит ограничения в браузер: их приходится знать поимённо и закрывать тестами.
Доступность
Все семь приложений открыты и работают в браузере без установки. Первая загрузка занимает до полуминуты — браузер загружает сам Python; дальше всё считается на месте, без обращений к серверу. Исходный код — на GitHub и GitFlic.
- Playground’ы: konkin-nikita.ru/gd_learn
- Исходный код: github.com/nikita-konkin/gd_learn
Теги
Другие обновления по проекту
Площадки по ML: тёмная тема для Streamlit без перезапуска и ошибка, которую нашла подсветка
Переключатель темы на всех страницах сайта, который перекрашивает площадки на Streamlit без перезапуска Python; объяснение данных на площадке об утечке, где подсветка настоящих ...
ML Playgrounds: второй курс, каталог по темам и числа, которые зависят от версии библиотеки
К площадкам курса машинного обучения для магистратуры добавились шесть площадок бакалаврского курса программирования систем ИИ на Python, а сайт стал общим каталогом по темам. Ч...