Площадки по ML: пояснения по шагам, общий глоссарий и определения при наведении
Все 13 площадок перестроены в пронумерованные шаги, где каждая диаграмма предварена объяснением; 71 термин собран в общий глоссарий, а на площадках определение всплывает при наведении на подчёркнутое слово; кривая «точность — полнота» объяснена через снижение порога и идеальную модель.
Площадки писались как приложение к лекциям. Тому, кто помнит лекцию, подписи понятны; тому, кто пришёл из поиска, — нет: термины используются без определений, а графики появляются раньше, чем сказано, что на них. За неделю площадки получили три изменения, которые закрывают этот разрыв: порядок по шагам, общий глоссарий и определения прямо в тексте.
Площадка как последовательность шагов
Все 13 площадок перестроены по одному правилу: разделы пронумерованы и идут в том порядке, в каком их нужно читать, а каждая диаграмма предварена абзацем о том, что на ней и откуда она берётся. Пример — площадка об утечке данных. Раньше она начиналась сразу с итоговых чисел, теперь это шесть шагов: данные и задача, как проверяют модель, два порядка шагов — с утечкой и честно, — результат по блокам, что отобралось и почему шум выглядит значимым.
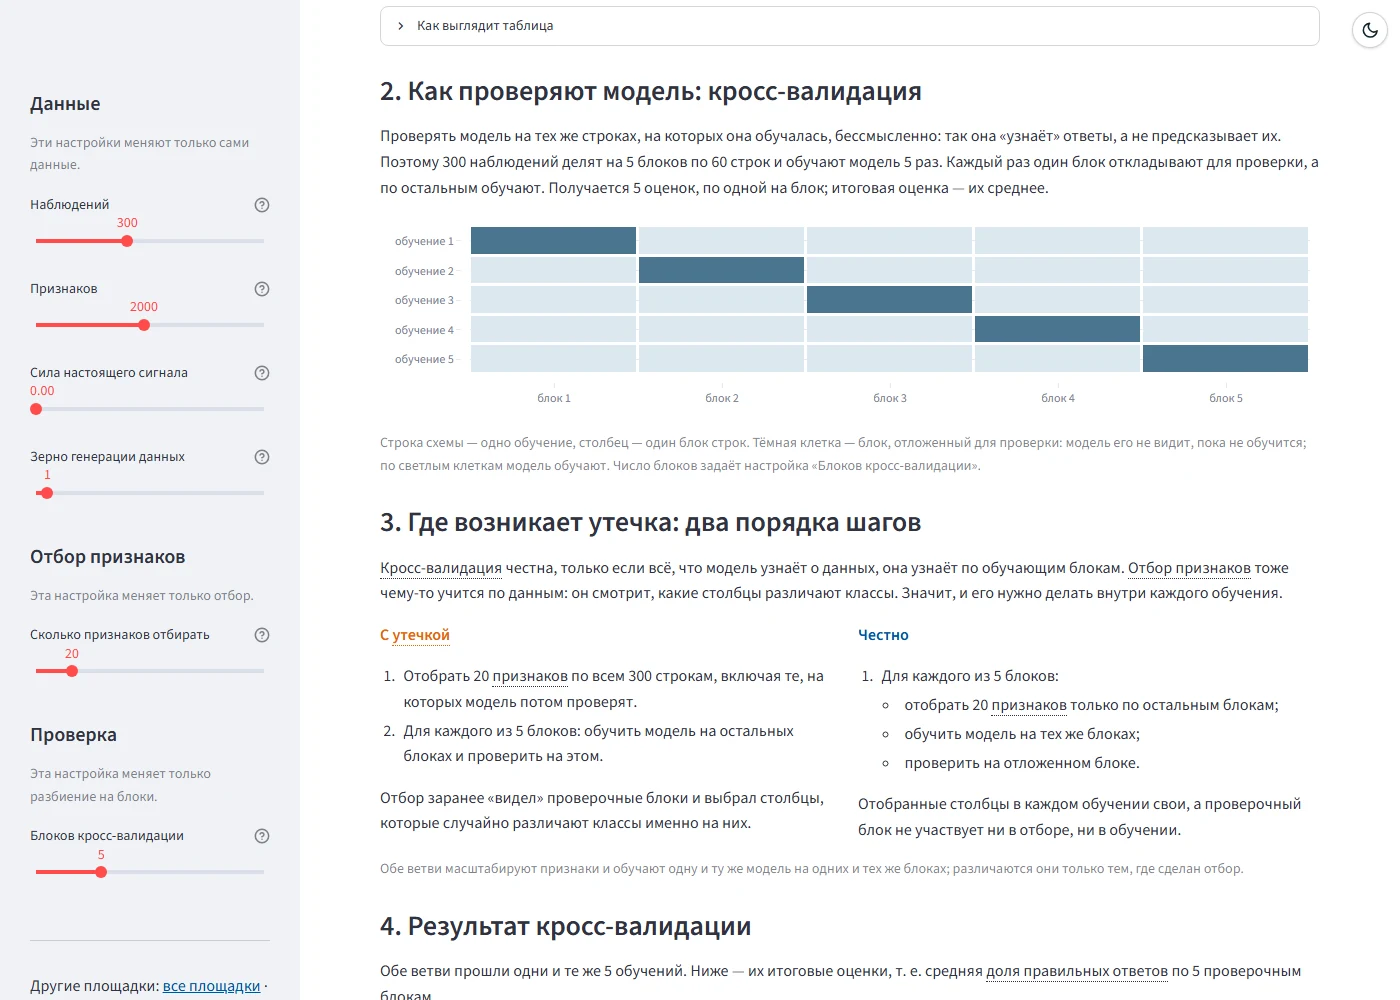
Для второго шага появилась новая схема: строка — одно обучение, столбец — один блок строк, тёмная клетка — блок, отложенный для проверки. Число блоков задаёт ползунок, и схема перестраивается вместе с ним. Третий шаг ставит рядом два порядка действий. С утечкой: сначала отобрать 20 признаков по всем 300 строкам, затем обучать по блокам. Честно: отбирать признаки заново в каждом обучении, только по обучающим блокам. Обе ветви масштабируют признаки и обучают одну и ту же модель на одних и тех же блоках — различаются они только тем, где сделан отбор.
На остальных площадках то же правило дало свои перестановки. Нейросеть показывает сеть и код обратного прохода до обучения, а ошибка, выбранная слева, видна в этом коде как одна заменённая строка. Граф задач начинается с графа и правил планировщика, а итог и журнал идут после. Подготовка данных показывает цепочку очистки явно, шаг за шагом. На площадке о векторизации текста accuracy названа долей правильных ответов, а справки к параметрам min_df и sublinear_tf исправлены.
Общий глоссарий
Одни и те же понятия встречаются на многих площадках: доля правильных ответов — на пяти, кросс-валидация — на четырёх. Два разных определения одного и того же путают сильнее, чем отсутствие определения, поэтому все термины живут в одном словаре в общем модуле. У каждого есть название, смысл, при необходимости формула и примечание. Сейчас в словаре 71 термин; последними добавлены восемь, которые площадки использовали без определения: признак, логистическая регрессия, сигмоида, ReLU, перекрёстная энтропия, стандартизация, плейсхолдер и кластеризация.
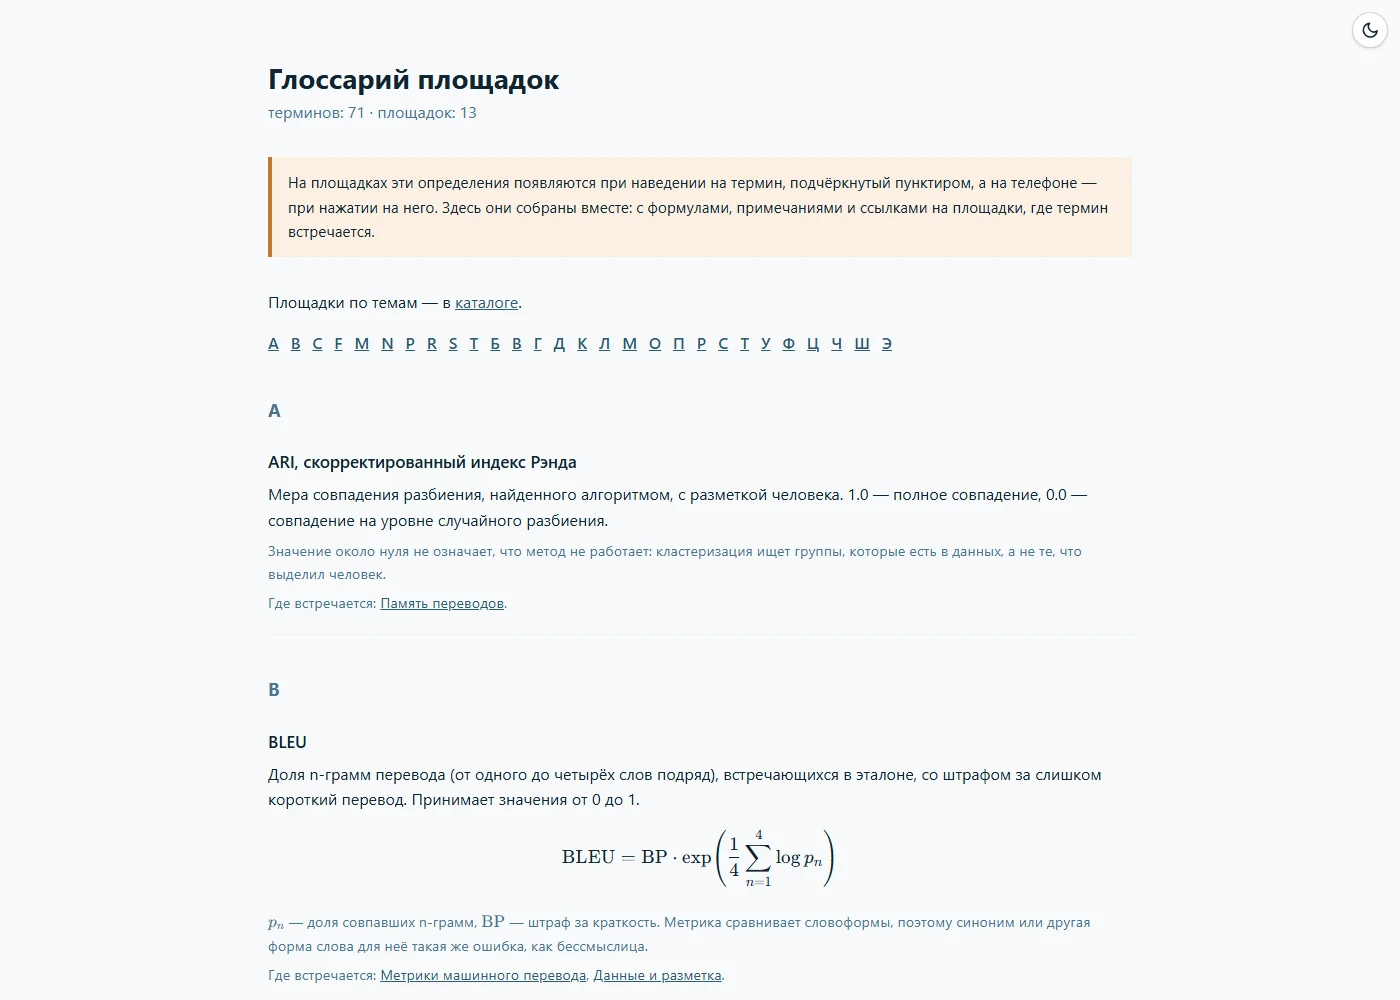
Из словаря при сборке сайта получается отдельная страница — глоссарий: термины по алфавиту, сначала латинские, затем русские, с формулами, примечаниями и списком площадок, где термин встречается. Ссылка на неё есть в боковой панели каждой площадки, в каталоге и на странице курса.
Определение при наведении
На самих площадках словарь работает прямо в тексте. Первое упоминание термина в каждом блоке пояснений подчёркнуто пунктиром; при наведении мыши появляется определение. На телефоне наведения нет, поэтому определение открывается нажатием и встаёт полосой у нижнего края экрана.
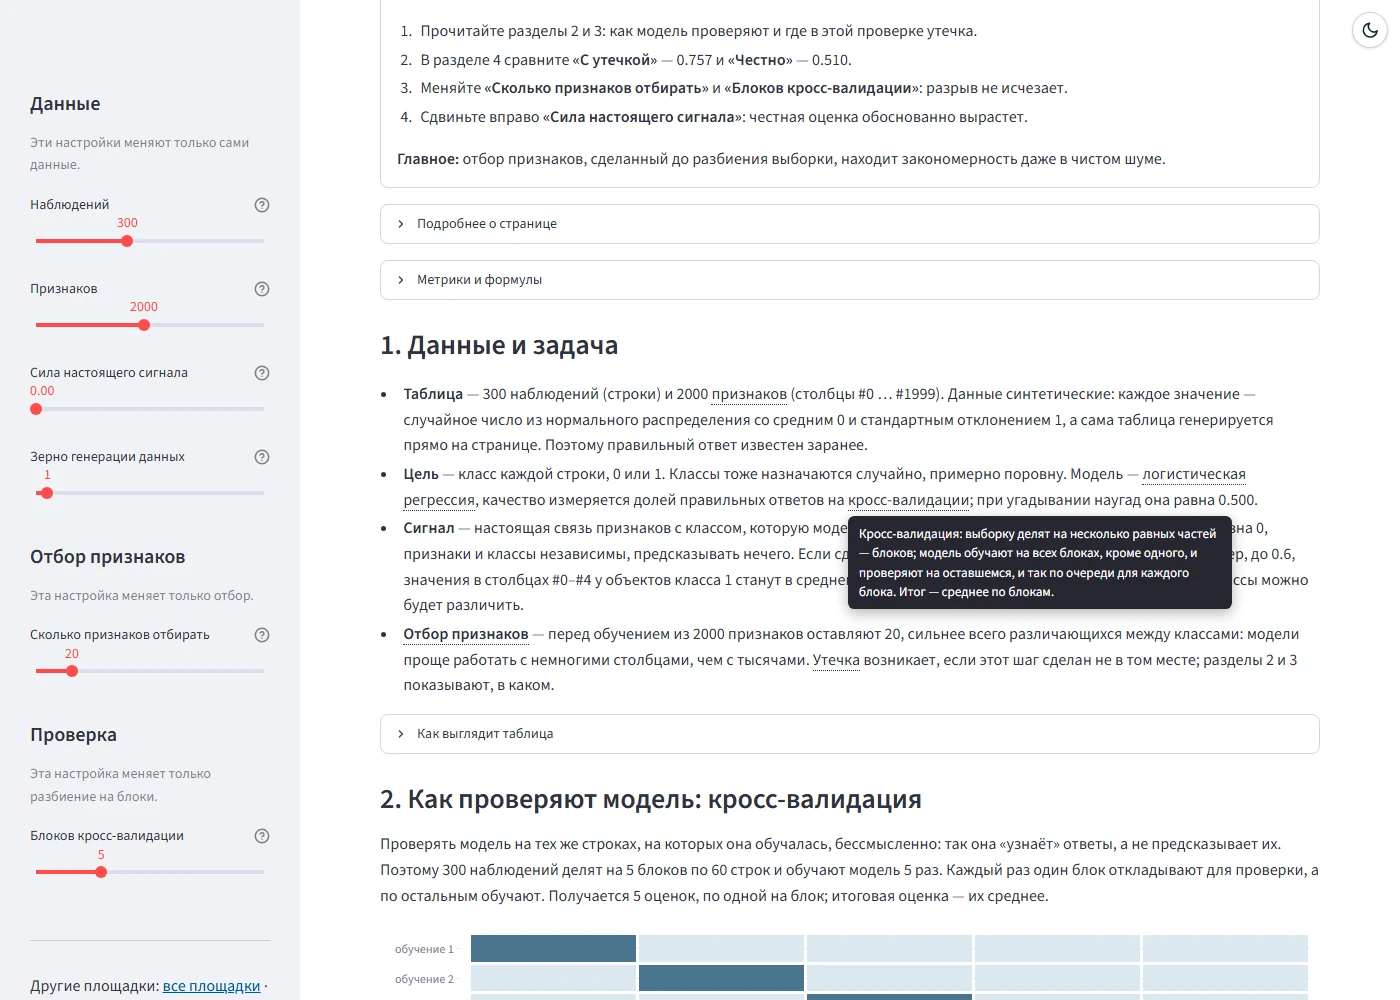
Каждая площадка объявляет, какие термины она объясняет, и ищутся только они. Причина в том, что одно слово значит разное на разных страницах: «пропуск» на площадке о подготовке данных — это пустая ячейка в таблице, а на площадке о метриках — пропущенный отказ. Для каждого термина задан шаблон, который ловит его падежные формы. Упоминания внутри жирных названий элементов управления, кода, формул и готового HTML не трогаются, чтобы подсказка не сломала разметку. Тесты проверяют, что каждый термин, который просит страница, есть в словаре и имеет шаблон, что подчёркивается только первое упоминание, что названия элементов управления и код остаются нетронутыми и что страница объявляет свои термины раньше любого пояснения.
Кривая «точность — полнота»
Площадка о метрике и дисбалансе классов показывает кривую «точность — полнота» для трёх способов учесть перекос. Пояснение к ней теперь объясняет, как её читать. Кривую проходят слева направо, постепенно снижая порог. При высоком пороге модель объявляет отказом лишь несколько самых подозрительных деталей и почти не ошибается: полнота мала, точность близка к 1. Чем ниже порог, тем больше отказов найдено и тем больше среди тревог ложных.
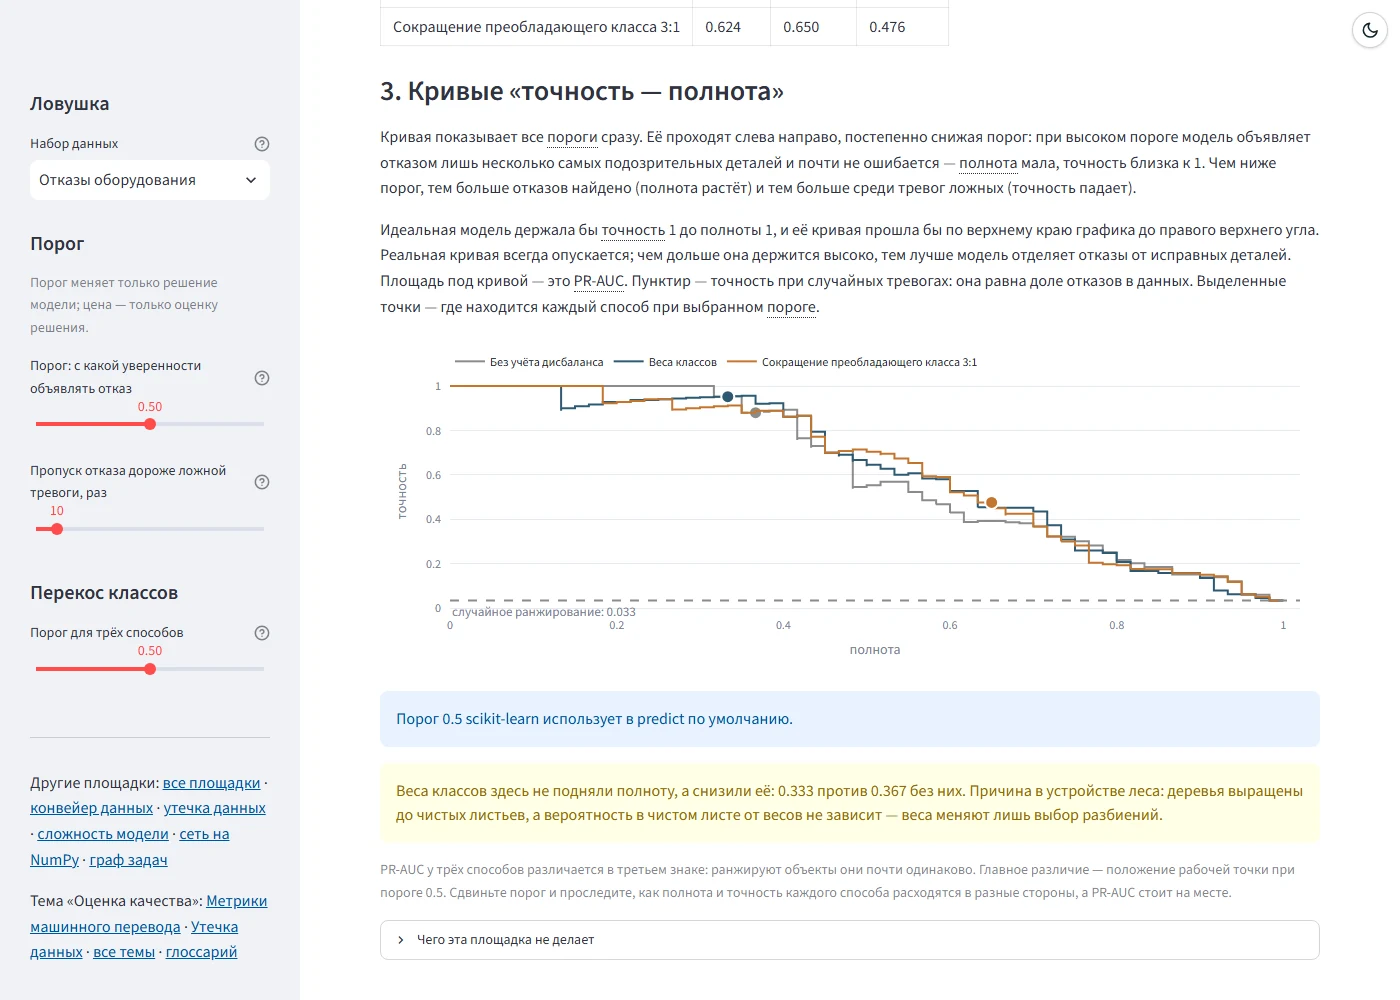
Ориентиром служит идеальная модель: она держала бы точность 1 вплоть до полноты 1, и её кривая прошла бы по верхнему краю графика до правого верхнего угла. Реальная кривая всегда опускается; чем дольше она держится высоко, тем лучше модель отделяет отказы от исправных деталей. Площадь под кривой — PR-AUC. Пунктир внизу — точность случайных тревог, которая равна доле отказов в данных; здесь это 0,033.
Выводы под графиком не написаны заранее, а вычисляются из данных. На этом наборе веса классов не подняли полноту, а снизили её — 0,333 против 0,367 без них, — и площадка объясняет почему: деревья случайного леса выращены до чистых листьев, а вероятность в чистом листе от весов не зависит.
Ещё одна подпись к замеру скорости
В прошлом разборе замер скорости научился работать с огрублёнными часами браузера. Когда числа стали видны, обнаружилось, что подпись под замером обещала лишнее: скалярное произведение в браузере оказалось медленнее поэлементного варианта, 556 мкс против 379 на миллионе чисел, хотя в обычном Python оно в 11 раз быстрее. Теперь подпись говорит то, что измерено здесь, а подпись к самому длинному столбцу больше не обрезается краем графика.
Выводы
- Пояснение полезно, когда оно идёт до графика: читатель сначала узнаёт, что увидит, и только потом смотрит.
- Один словарь на все страницы не даёт одному понятию получить два разных определения.
- Подсказка при наведении должна знать контекст страницы: одно и то же слово в разных разделах может означать разное.
- Кривую легче читать через движение по ней — снижение порога — и через идеальный случай, с которым её сравнивают.
Доступность
Площадки открываются в браузере без установки, исходный код открыт.
- Площадки: konkin-nikita.ru/gd_learn/topics
- Глоссарий: konkin-nikita.ru/gd_learn/glossary
- Исходный код: github.com/nikita-konkin/gd_learn
Теги
Другие обновления по проекту
Площадки по ML: тёмная тема для Streamlit без перезапуска и ошибка, которую нашла подсветка
Переключатель темы на всех страницах сайта, который перекрашивает площадки на Streamlit без перезапуска Python; объяснение данных на площадке об утечке, где подсветка настоящих ...
ML Playgrounds: второй курс, каталог по темам и числа, которые зависят от версии библиотеки
К площадкам курса машинного обучения для магистратуры добавились шесть площадок бакалаврского курса программирования систем ИИ на Python, а сайт стал общим каталогом по темам. Ч...