Открытый диплом: прототип на Java 11 и сверка, в которой XML совпали побайтно
Черновик архитектуры открытой замены «КиберДиплома» получил прототип и собственный репозиторий. Что прототип умеет, какие критерии выбора стека уже измерены, а какие нет, как перенос правил проверен сравнением с текущим сервисом на всём архиве и почему учебный план в PDF пришлось читать по линиям таблицы.
В прошлом разборе архитектура открытой замены «КиберДиплома» была черновиком, а выбор Java 11 — обоснованной гипотезой с названным запасным вариантом. Теперь у проекта есть имя, собственный репозиторий под лицензией Apache 2.0 и прототип: «Открытый диплом».
Прототип — не MVP. Картотеки выпускников и печати на бланках в нём ещё нет. Его задача другая: проверить выбранный стек по заранее записанным критериям и перенести правила текущего сервиса так, чтобы в переносе можно было быть уверенным.
Что умеет прототип
Программа — один файл open-diplom.jar со встроенным Tomcat 10.1. В настольном режиме она слушает только 127.0.0.1, сама открывает браузер и создаёт рядом папку с базой SQLite. Страницы — обычный HTML без скриптов.
- Импорт ведомости «Деканата» в
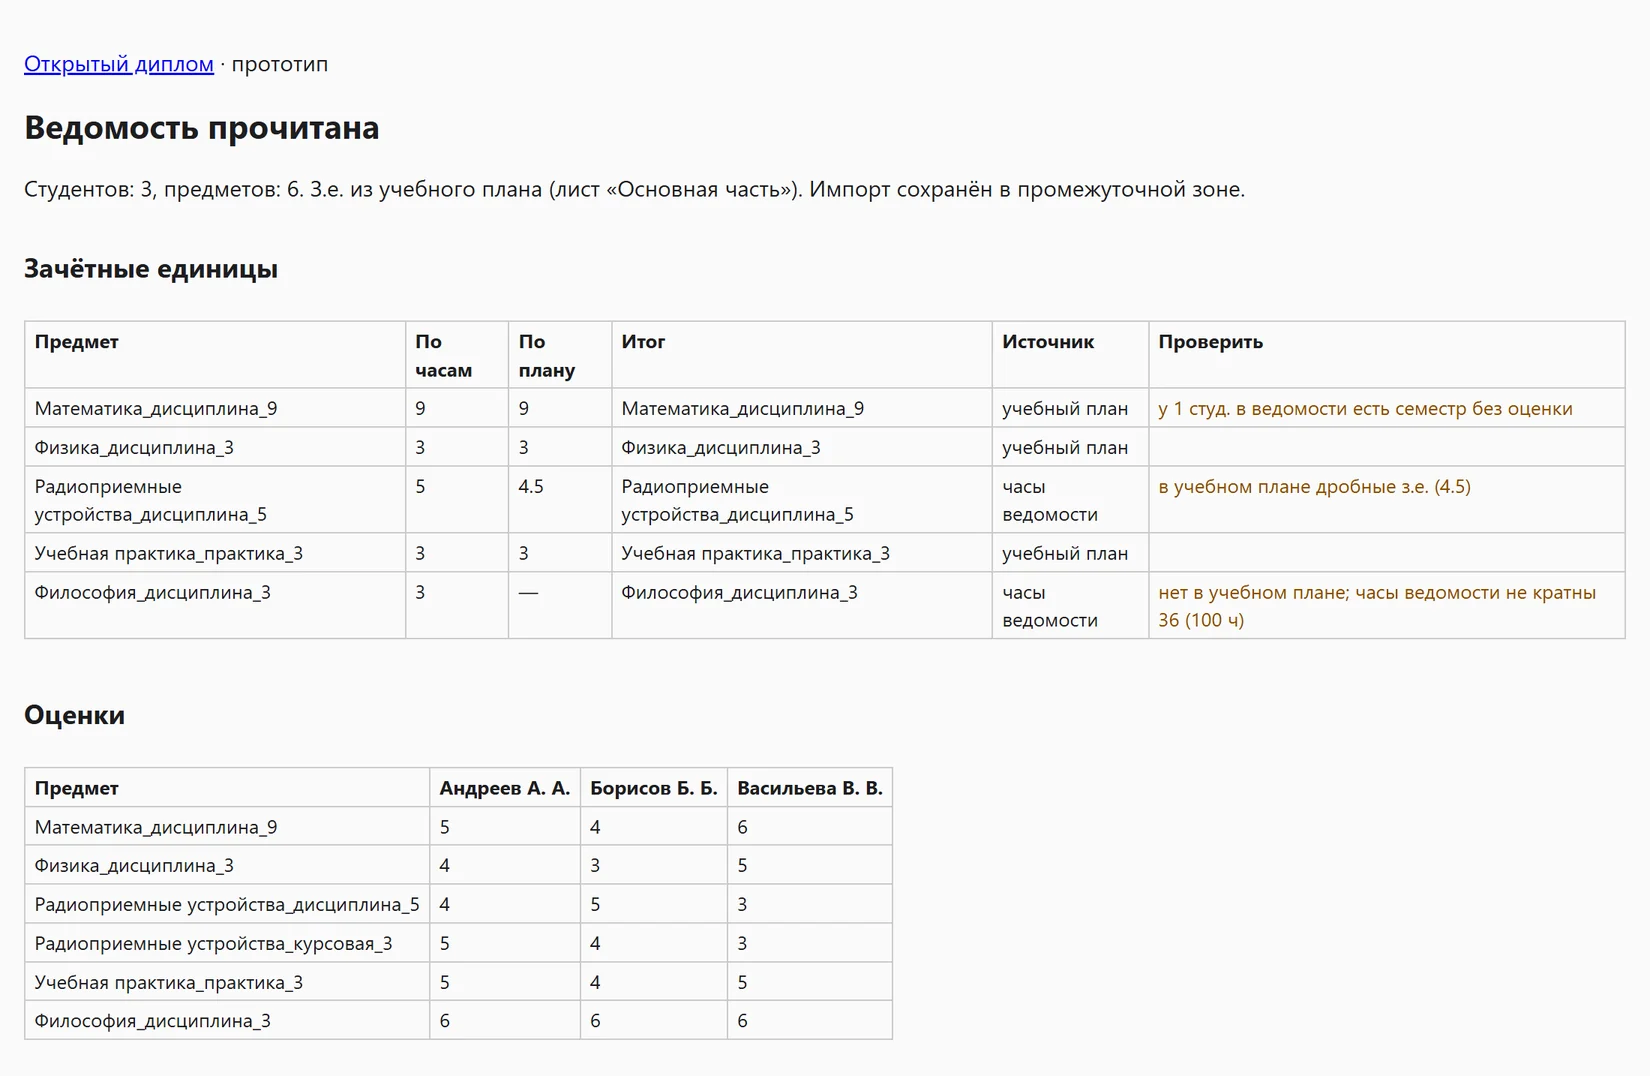
.xlsили.xlsx, по желанию вместе с учебным планом — в Excel или в PDF, сохранённом из «Планов». Семестры складываются, зачётные единицы берутся из плана, спорные строки помечаются для оператора, результат сохраняется в промежуточной зоне. - XML для «КиберДиплома» из сводной таблицы и сведений о студентах — на переходный период, пока печать остаётся за ним.
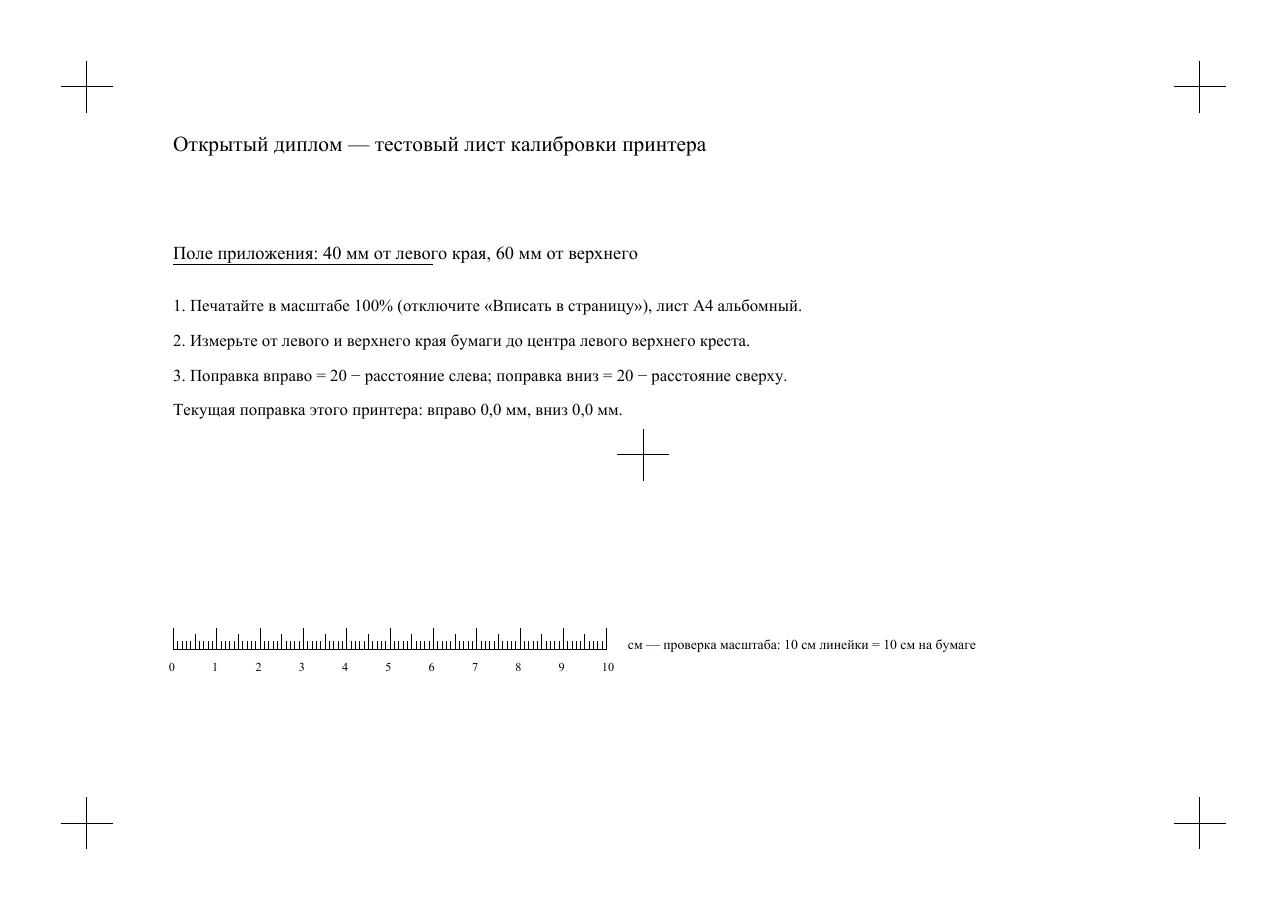
- Тестовый лист калибровки принтера — PDF с поправками вправо и вниз в миллиметрах.
Критерии, записанные заранее
Критерии выбора стека были записаны до прототипа. Теперь почти по всем есть цифры — замеры сделаны в Linux-контейнерах на Mac, на двух архитектурах: arm64 и x86-64 (через эмуляцию Rosetta):
- запуск без установки: урезанный рантайм занимает 51–56 МБ, сама программа — 39 МБ;
- время запуска: 0,3 с на arm64 и 0,7 с на x86-64 при требовании меньше пяти секунд;
- память: пик 243 и 276 МБ при требовании меньше 300 МБ;
- PDF в миллиметрах: поле стоит в PDF на заданном месте с точностью 0,5 мм, и поправка калибровки его сдвигает — тесты читают координаты обратно из файла.
С памятью связана самая поучительная деталь. С настройками JVM по умолчанию пик составил 402 МБ — критерий был бы провален. Уложиться позволили три параметра запуска: куча 128 МБ, последовательный сборщик мусора и только компилятор C1. Поэтому их задаёт сам запускатель, а не пользователь.
Не менее важно то, что пока не проверено. Главный риск — 32-битная Windows 7 с 2 ГБ памяти — остаётся непроверенным: стенды отложены. Отпечаток на бумаге тоже не измерен, для этого нужен принтер, на котором печатаются бланки. Прототип честно отделяет измеренное от предположенного.
Перенос, проверенный сравнением
Правила текущего сервиса — чтение ведомости, сложение семестров, зачётные единицы из плана, проверки сведений и выгрузка XML — переписаны с Python на Java. Как убедиться, что при переписывании ничего не изменилось?
Первый уровень — тесты: их 91, и 44 сценария перенесены из Python-тестов текущего сервиса. Второй — проверка поломками. В копию кода по очереди вносились ошибки: убирался приоритет экзамена, отключалась поправка калибровки, государственный экзамен ставился после защиты выпускной работы, имена файлов читались в неверной кодировке. Каждую поломку тесты поймали. Одну — удаление явной настройки UTF-8 — не заметили, и это верно: Tomcat 10.1 читает имена в UTF-8 и без неё.
Третий уровень — сверка на реальных данных. Обе реализации, на Python и на Java, прогнаны по всем 93 книгам архива 2019–2026 годов: 105 разборов ведомостей, 93 чтения учебного плана и 60 пар «сводная таблица × сведения о студентах». Сверка шла локально, данные никуда не передавались. Расхождений нет; готовые XML совпали побайтно.
Побайтное совпадение — сильное утверждение, и именно поэтому оно полезно: любое будущее изменение правил можно проверить той же сверкой.
Что намеренно не перенесено
Не всё из текущего сервиса заслуживает переноса. Сопоставление строк ведомости со «Списком дисциплин» — эвристика по подстрокам, и именно из неё выросли ошибки, найденные при ревизии. В новой системе строки ведомости сопоставляются с учебным планом в промежуточной зоне, а оператор подтверждает результат. Факультативы будут определяться по блоку ФТД учебного плана, а не по списку дисциплин.
Перенос — удобный момент, чтобы не только сохранить работающее, но и оставить позади то, что работало плохо.
Учебный план из PDF
Учебные планы приходят в основном в PDF, сохранённом из «Планов». Текст в таком файле есть, а ячеек нет: только буквы с координатами и линии сетки. Длинное название дисциплины переносится на две–четыре строки выше и ниже строки с индексом, причём промежуток между этими строками такой же, как между соседними строками таблицы. По одному тексту строки таблицы не восстановить.
Поэтому план читается по сетке: строки таблицы — промежутки между горизонтальными линиями, колонки — между вертикальными. Номера колонок в разных планах стоят по-разному, так что зачётные единицы берутся из первой колонки под заголовком «в зачетных единицах», а название — из колонки под «Структура ОП». Итоги блоков пропускаются: в Excel-версии плана их нет в колонке названий, и так один и тот же план даёт одинаковые единицы в обоих форматах.
Результат на архиве: прочитаны все пять PDF-планов с текстом; два плана бакалавриата сверены с Excel-планами тех же профилей годом раньше (набор 2021 года против 2022-го) и совпали в 51 из 51 и 59 из 59 зачётных единиц. Ещё два файла оказались сканами без текста — их программа не принимает и прямо об этом сообщает: «похоже, это скан».
Поля XML из учебного плана
Раньше объём программы, аудиторные часы и зачётные единицы практик и ГИА оператор вписывал в форму вручную для каждой программы — а ручной ввод повторяющихся чисел и есть место, где рождаются ошибки. Теперь кнопка «Заполнить из плана» заполняет девять полей из десяти: направление и профиль, квалификацию, форму и срок обучения — из шапки плана, объёмы — из его итогов.
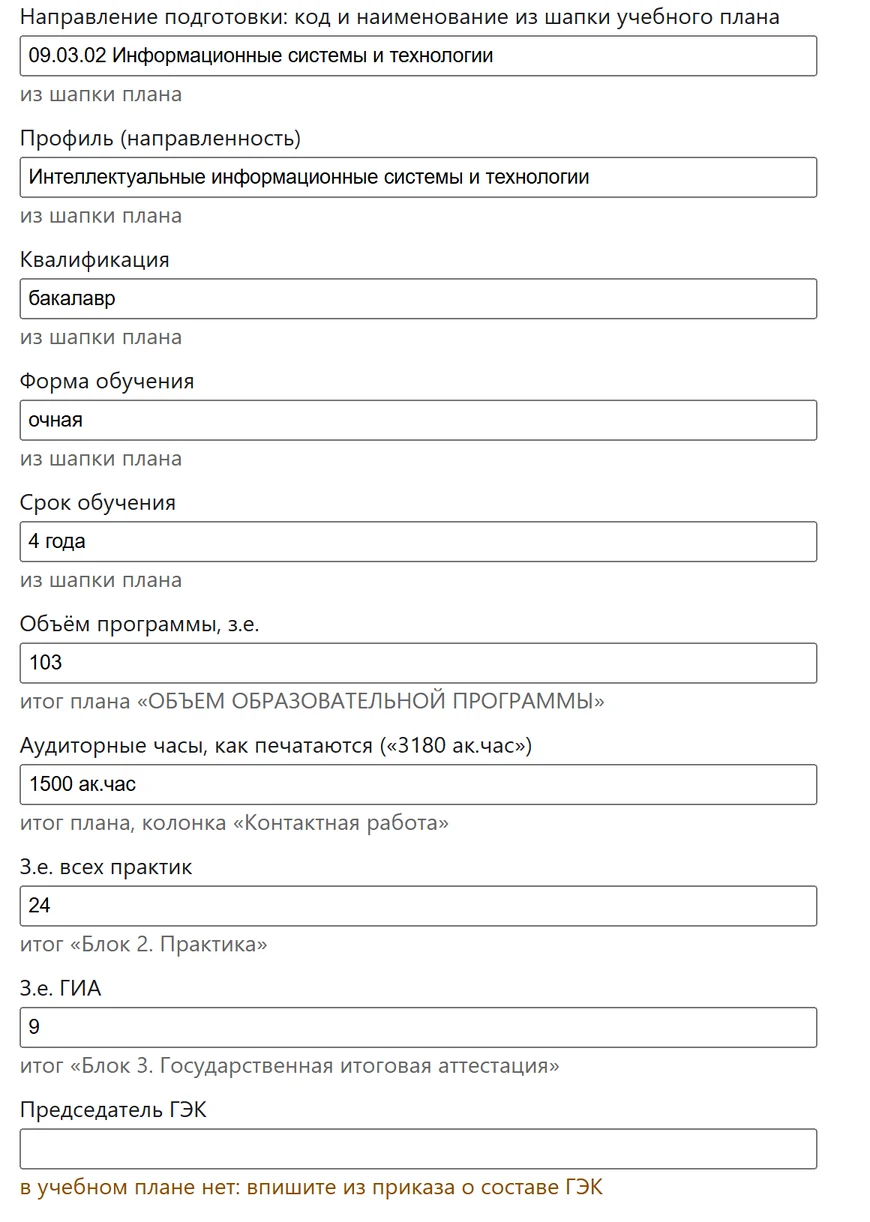
Два правила стоит отметить. Аудиторные часы берутся из итоговой строки, только если её часы сходятся: всего равно экзаменам плюс занятиям, а занятия — контактной работе плюс самостоятельной. Если не сходятся, поле остаётся пустым и помечается. Срок обучения берётся нормативный для очной формы при любой форме — так решил владелец процесса, и так печатались приложения прошлых лет. Проверка на пяти планах 2023–2026 годов: все четыре числа совпали с напечатанными приложениями.
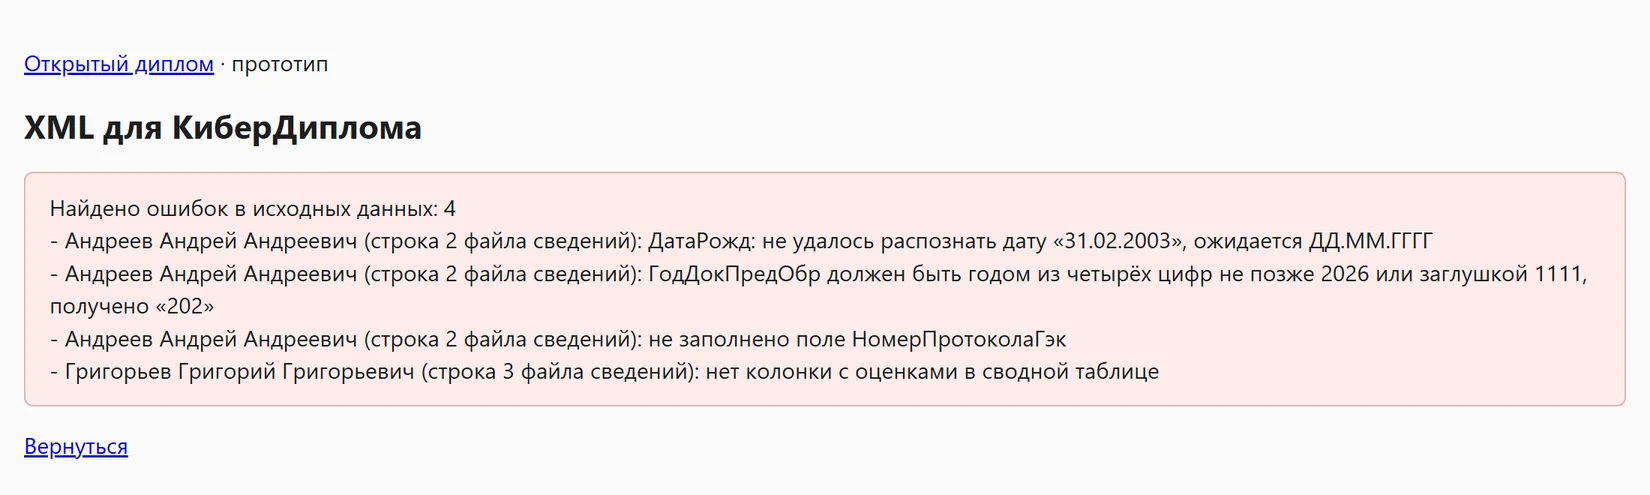
Проверки сведений о студентах перенесены вместе с главным принципом ревизии — все ошибки сразу, одним списком:
Калибровка
Печать на бланках пока не реализована, но её основа уже есть: PDF с полем в заданных миллиметрах и калибровка принтера. Тестовый лист печатается в масштабе 100%, после чего линейкой измеряется расстояние до креста в углу; поправки вычисляются по формуле, напечатанной на самом листе. Линейка в 10 см на листе проверяет, что принтер не масштабировал страницу.
Дальше
Следующие шаги расставлены по риску. Сначала стенды: 32-битная Windows 7 и Astra Linux, а заодно проверка Java 17 на 32-битной Windows — для Java 11 многие библиотеки уже не обновляются. Затем тестовый лист на том принтере, где печатаются бланки. Поставку можно уменьшить: в программу сейчас попадают библиотеки SQLite для всех платформ, а нужны только Windows и Linux. И наконец — начало MVP: модель данных картотеки и сопоставление ведомости с учебным планом в промежуточной зоне.
Выводы
- Критерии, записанные до прототипа, превращают выбор стека из мнения в измерение. Без них 402 МБ памяти легко было бы счесть приемлемыми.
- Настройки, от которых зависит соблюдение требований, должны задаваться программой, а не пользователем: запускатель фиксирует параметры JVM.
- Перенос кода между языками проверяется не только тестами, но и сверкой на реальных данных: побайтное совпадение — самый строгий и самый дешёвый критерий.
- Переписывание — повод не переносить то, что было источником ошибок: эвристика по подстрокам заменена сопоставлением с подтверждением оператора.
- Прототип полезен настолько, насколько честно отделяет измеренное от непроверенного: главный риск — старая 32-битная Windows — назван прямо.
Доступность
Проект открыт под лицензией Apache 2.0; архитектура и записи решений лежат в каталоге docs/architecture/, результаты прототипа — в docs/prototype.md. Тесты не используют реальных данных: книги и PDF строятся в памяти.
- Исходный код: github.com/nikita-konkin/open-diplom
Теги
Другие обновления по проекту
Открытый диплом: от ведомости до бланка — выпуск, документы, печать и учёт бланков
За неделю прототип «Открытого диплома» прошёл весь путь выпуска: сопоставление ведомости группы с учебным планом, картотека и регистрационные номера, правки поверх файлов, печат...
Открытый диплом: учебные планы по годам набора и редакциям
Учебный план стал в «Открытом дипломе» самостоятельной сущностью: планы хранятся по программе, форме обучения и году набора, каждая правка сохраняется новой редакцией, контрольн...